Pattern di decomposizione e migrazione
Questi pattern rispondono a due domande: come dividere un sistema in servizi con confini sensati, e come passare da un monolite esistente ai microservizi senza fermare il business. Ci sono anche i pattern di infrastruttura che spostano fuori dal codice i compiti ripetitivi (proxy, TLS, log).
| Pattern | Problema che risolve | Usalo quando |
|---|---|---|
| Decompose by Business Capability | Confini dei servizi arbitrari o tecnici | L'organizzazione ha funzioni di business chiare e stabili |
| Decompose by Subdomain | Un modello unico che non regge per tutti | Il dominio è complesso e lo stesso termine cambia significato |
| Strangler Fig | Riscrittura big bang troppo rischiosa | Devi migrare un monolite in produzione un pezzo alla volta |
| Anti-Corruption Layer | Il modello legacy contamina il nuovo servizio | Il nuovo servizio deve parlare con un sistema vecchio o esterno |
| Branch by Abstraction | Sostituire un componente senza branch lunghi | Il cambiamento è interno al codice e serve rilascio continuo |
| Parallel Run | Paura che il nuovo sistema sbagli | Il risultato è critico e deve coincidere con il vecchio |
| Sidecar | Codice ripetuto in ogni servizio per log, TLS, proxy | Servizi in linguaggi diversi con esigenze comuni |
| Ambassador | Logica di connessione verso l'esterno duplicata | Molte chiamate in uscita con retry, auth, routing |
| Service Mesh | Gestire sidecar a mano su decine di servizi | Tanti servizi e serve mTLS, tracing, routing centralizzati |
| Self-contained Service vs Shared Library | Una libreria condivisa accoppia i servizi di nascosto | Devi decidere se condividere codice o duplicarlo |
flowchart TD
    subgraph taglio["✂️ Come dividere"]
        cap["🏢 Decompose by Business Capability"]
        sub["🗺️ Decompose by Subdomain"]
    end
    subgraph migra["🚚 Come migrare senza fermarsi"]
        fig["🌿 Strangler Fig"]
        acl["🛡️ Anti-Corruption Layer"]
        bba["🔀 Branch by Abstraction"]
        par["⚖️ Parallel Run"]
    end
    subgraph infra["🧰 Cosa spostare fuori dal codice"]
        side["🛵 Sidecar"]
        amb["🤝 Ambassador"]
        mesh["🕸️ Service Mesh"]
    end
    subgraph cond["📚 Cosa condividere"]
        lib["📦 Self-contained Service vs Shared Library"]
    end
Da monolite a microservizi
Un monolite non è un errore. È la scelta giusta quando il team è piccolo, il dominio è ancora poco chiaro o il traffico è gestibile. I microservizi hanno senso quando più team devono rilasciare in modo indipendente, quando parti del sistema hanno bisogni di scalabilità molto diversi, o quando un guasto in una funzione non deve fermare le altre.
Il costo dei microservizi è alto: rete, consistenza dei dati, osservabilità, rilascio. Se il problema è solo "il codice è disordinato", la risposta è il monolite modulare: un solo processo, ma diviso in moduli con confini espliciti, ognuno con il proprio schema dati e un'interfaccia pubblica. Il monolite modulare è anche il miglior punto di partenza per una futura migrazione: i confini dei moduli diventano i confini dei servizi.
flowchart LR
    mono["Monolite"] --> modular["Monolite modulare"]
    modular --> micro["Microservizi"]
    modular -. "spesso basta fermarsi qui" .-> stop["Fine"]
Decompose by Business Capability
In una frase: Dividi il sistema seguendo le funzioni di business dell'azienda, non i livelli tecnici.
Problema che risolve: Molti sistemi sono divisi per tecnologia: un servizio "database", uno "API", uno "frontend". Ogni funzionalità nuova tocca tutti e tre e i team si bloccano a vicenda. Serve un criterio di divisione che segua il valore prodotto, così che una modifica di business resti dentro un solo servizio.
Come funziona:
flowchart LR
    azienda(["🏢 Azienda e-commerce"])
    azienda -->|"vendere"| vend["👔 Team Vendite - Catalogo, Ordini"]
    azienda -->|"incassare"| fin["💰 Team Finanza - Pagamenti"]
    azienda -->|"spedire e avvisare"| log["🚚 Team Logistica - Magazzino, Notifiche"]
flowchart TD
azienda["E-commerce"] --> cat["Gestione catalogo"]
azienda --> ord["Gestione ordini"]
azienda --> pag["Gestione pagamenti"]
azienda --> mag["Gestione magazzino"]
azienda --> not["Notifiche clienti"]
cat --> svcCat["Servizio Catalogo"]
ord --> svcOrd["Servizio Ordini"]
pag --> svcPag["Servizio Pagamenti"]
mag --> svcMag["Servizio Magazzino"]
not --> svcNot["Servizio Notifiche"]- Elenca cosa fa l'azienda per generare valore: vendere prodotti, incassare, spedire, avvisare i clienti.
- Ogni capacità di business è stabile nel tempo, anche se la tecnologia cambia.
- Ogni capacità diventa un servizio con i propri dati e la propria API.
- Un team è responsabile di una o più capacità, dall'inizio alla fine.
Quando usarlo: - L'organizzazione ha reparti o funzioni di business chiare (vendite, logistica, amministrazione). - Vuoi che la struttura dei servizi rispecchi la struttura dei team. - Il dominio è relativamente semplice e i termini hanno un significato unico.
Quando NON usarlo / rischi: - Le capacità di business sono troppo ampie: "Gestione ordini" può diventare un mini monolite. - L'organigramma è instabile: i servizi seguirebbero le riorganizzazioni. - Non chiarisce cosa fare quando lo stesso concetto (es. "prodotto") è usato da più capacità.
Esempio pratico: Un e-commerce nato come monolite ha tre team che lavorano tutti sullo stesso codice. Si individuano le capacità: catalogo, ordini, pagamenti, magazzino, notifiche. Il team logistica prende Magazzino e Notifiche, il team vendite prende Catalogo e Ordini, il team finanza prende Pagamenti. Ogni team rilascia il proprio servizio senza coordinarsi con gli altri.
Pattern correlati: Decompose by Subdomain, Database per Service, Strangler Fig
Decompose by Subdomain
In una frase: Dividi il sistema seguendo i sottodomini del Domain-Driven Design, ognuno con il proprio modello e il proprio linguaggio.
Problema che risolve: La parola "prodotto" significa cose diverse per il catalogo (descrizione, foto, prezzo), per il magazzino (codice, peso, scaffale) e per gli ordini (riga, quantità, sconto). Un modello unico che accontenta tutti diventa enorme e fragile. Serve dividere il dominio in zone dove ogni termine ha un significato preciso.
Come funziona:
flowchart LR
esperto(["🧑💼 Esperto di dominio"]) -->|"dice: prodotto"| cat["🛍️ Catalogo - nome, foto, prezzo"]
esperto -->|"dice: prodotto"| ord["📦 Ordini - riga, prezzo al momento"]
esperto -->|"dice: prodotto"| mag["🏭 Magazzino - codice, peso, scaffale"]
nota["💡 Stessa parola, tre modelli diversi"]
cat -.- nota
ord -.- nota
mag -.- notaflowchart LR
subgraph core["Core domain"]
ordini["Ordini - bounded context"]
pagamenti["Pagamenti - bounded context"]
end
subgraph supporting["Supporting domain"]
catalogo["Catalogo - bounded context"]
magazzino["Magazzino - bounded context"]
end
subgraph generic["Generic domain"]
notifiche["Notifiche - bounded context"]
end
catalogo -- "Prodotto pubblicato" --> ordini
ordini -- "Ordine confermato" --> pagamenti
ordini -- "Ordine confermato" --> magazzino
pagamenti -- "Pagamento accettato" --> notifiche
magazzino -- "Spedizione pronta" --> notifiche- Il dominio e-commerce viene diviso in sottodomini: core (dove l'azienda compete: ordini, pagamenti), supporting (necessari ma non distintivi: catalogo, magazzino), generic (comprabili sul mercato: notifiche).
- Ogni sottodominio ha un bounded context: un confine dentro cui il modello e i termini sono coerenti.
- "Prodotto" esiste in Catalogo, Ordini e Magazzino, ma con attributi diversi: non si condivide la classe, si condividono eventi.
- Le frecce sono le relazioni fra context, di solito eventi o API, con una traduzione sul confine.
- Ogni bounded context diventa un servizio (o un modulo del monolite modulare).
Quando usarlo: - Il dominio è complesso e gli esperti usano lo stesso termine con significati diversi. - Vuoi investire la qualità maggiore nel core domain e comprare o semplificare il resto. - I team hanno già fatto sessioni di modellazione (event storming) con il business.
Quando NON usarlo / rischi: - Il dominio è semplice: il DDD aggiunge vocabolario e cerimonia senza beneficio. - Confini sbagliati costano cari: un bounded context tagliato male genera chiamate continue fra servizi. - Richiede accesso agli esperti di dominio; senza di loro i confini sono inventati dagli sviluppatori.
Esempio pratico: Nel monolite la tabella prodotti ha 80 colonne usate da tutti. Si fa un event storming con il business e si scopre che il catalogo cambia prezzi e descrizioni, il magazzino cambia giacenze e posizioni, gli ordini vogliono solo nome e prezzo al momento dell'acquisto. Nascono tre bounded context; Ordini salva una copia del nome e del prezzo nella riga d'ordine e ascolta l'evento "Prodotto pubblicato" da Catalogo.
Pattern correlati: Decompose by Business Capability, Anti-Corruption Layer, Event Sourcing, Publish/Subscribe
Strangler Fig
In una frase: Metti una facciata davanti al monolite e sposta una funzionalità alla volta nei nuovi servizi, fino a spegnere il vecchio.
Problema che risolve: Riscrivere un monolite da zero e sostituirlo in un giorno è il modo più sicuro per fallire: mesi senza rilasci, funzionalità dimenticate, un cutover che non si può provare. Serve un modo per migrare mentre il sistema resta in produzione e ogni passo è reversibile.
Come funziona:
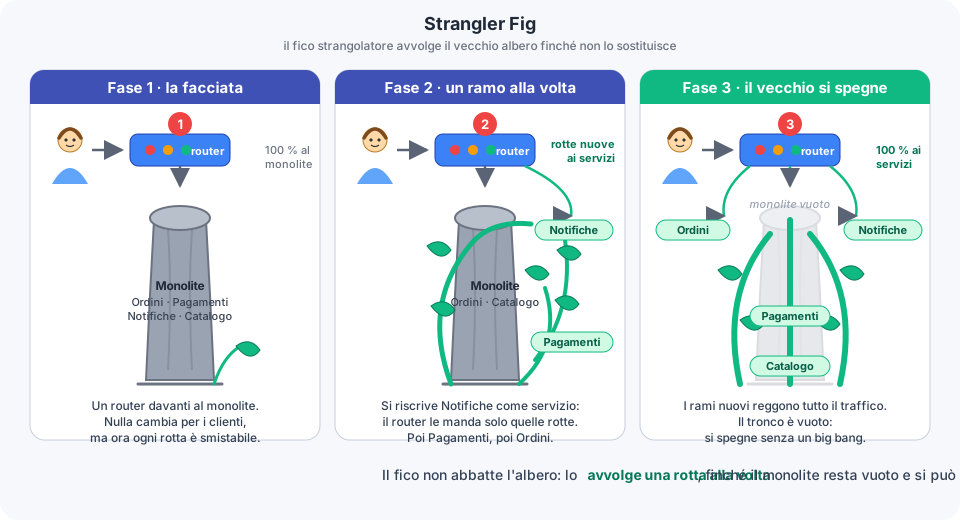
flowchart TD
    subgraph fase1["Fase 1 - facciata"]
        c1["Client"] --> f1["Facciata / Router"]
        f1 --> m1["Monolite"]
    end
    subgraph fase2["Fase 2 - migrazione graduale"]
        c2["Client"] --> f2["Facciata / Router"]
        f2 -- "/pagamenti" --> p2["Servizio Pagamenti"]
        f2 -- "/notifiche" --> n2["Servizio Notifiche"]
        f2 -- "tutto il resto" --> m2["Monolite"]
    end
    subgraph fase3["Fase 3 - spegnimento"]
        c3["Client"] --> f3["Facciata / Router"]
        f3 --> p3["Servizio Pagamenti"]
        f3 --> n3["Servizio Notifiche"]
        f3 --> o3["Servizio Ordini"]
end- Fase 1: si mette un router (API gateway, reverse proxy) davanti al monolite. Non cambia nulla per i client, ma ora ogni richiesta passa da un punto controllabile.
- Fase 2: si sceglie una funzionalità con pochi legami (es. Notifiche), si riscrive come servizio, e il router manda a lei solo quelle rotte. Il resto va ancora al monolite. Si ripete per Pagamenti, poi Ordini.
- Il monolite si "svuota" un pezzo alla volta; se un servizio nuovo ha problemi, il router torna a puntare al monolite.
- Fase 3: quando il monolite non serve più nulla, si spegne.
Quando usarlo: - Il monolite è in produzione e non puoi fermarlo. - Le funzionalità hanno punti di ingresso identificabili (URL, code, eventi). - Vuoi imparare facendo: la prima migrazione insegna come fare le altre.
Quando NON usarlo / rischi: - Il monolite condivide il database con tutto: spostare il codice senza spostare i dati crea un Distributed Monolith. - La migrazione si ferma a metà e si vive per anni con due sistemi: serve un piano con una fine. - Le funzionalità sono così intrecciate che non esiste un pezzo "con pochi legami" da cui partire.
Esempio pratico: L'e-commerce ha un monolite Django. Si mette Nginx davanti. Il primo pezzo migrato è Notifiche: le email di conferma ordine. Il nuovo servizio ascolta l'evento "Ordine confermato" e il monolite smette di inviare email. Poi tocca a Pagamenti: il router manda /api/pagamenti/* al nuovo servizio, che usa un Anti-Corruption Layer per leggere gli ordini ancora nel monolite. Dopo un anno il monolite gestisce solo il carrello, e viene riscritto per ultimo.
Pattern correlati: Anti-Corruption Layer, Branch by Abstraction, Parallel Run, API Gateway
Anti-Corruption Layer
In una frase: Un livello di traduzione che protegge il modello del nuovo servizio dal modello del sistema legacy o esterno.
Problema che risolve: Quando il nuovo servizio Pagamenti deve leggere ordini dal monolite, la tentazione è usare direttamente le sue tabelle o i suoi DTO. Così il modello vecchio, con i suoi nomi strani e i suoi campi nullable, entra nel nuovo codice e lo sporca. Dopo sei mesi il servizio nuovo è legato al vecchio quanto prima.
Come funziona:
flowchart LR
    pay["💳 Servizio Pagamenti"] -->|"chiede OrdineDaPagare"| acl["🛡️ Traduttore ACL"]
    acl -->|"legge ORD_TOT_LRD = 1.234,50"| legacy[("🏚️ Monolite legacy")]
    acl -->|"restituisce Decimal 1234.50"| pay
flowchart LR
nuovo["Servizio Pagamenti - modello nuovo"] --> acl["Anti-Corruption Layer"]
acl -- "traduce" --> legacy["Monolite - modello legacy"]
subgraph acl_dettaglio["Dentro l'ACL"]
adapter["Adapter - chiama il legacy"]
translator["Translator - converte i dati"]
facade["Facade - API pulita"]
end- Il servizio nuovo parla solo con la Facade dell'ACL, che espone concetti nel linguaggio nuovo (
Pagamento,ImportoDovuto). - L'Adapter sa come chiamare il legacy: query SQL, SOAP, file CSV, quello che c'è.
- Il Translator converte i dati legacy (
ORD_TOT_LRD, stringhe con virgola decimale) nel modello nuovo (Decimal,OrdineId). - Se il legacy cambia o viene spento, si cambia solo l'ACL. Il servizio nuovo non se ne accorge.
Quando usarlo: - Durante una migrazione Strangler Fig, fra servizi nuovi e monolite. - Integrando un sistema esterno (gestionale, ERP, gateway di pagamento) con un modello che non controlli. - Due bounded context con modelli molto diversi devono collaborare.
Quando NON usarlo / rischi: - I due modelli sono quasi uguali: l'ACL diventa codice che copia campi uno a uno. - È un pezzo in più da mantenere e testare; se il legacy cambia spesso, l'ACL cambia spesso. - Nasconde la complessità: chi legge il servizio nuovo non vede quanto è fragile l'integrazione.
Esempio pratico: Il monolite salva l'importo ordine in una colonna ORD_TOT_LRD come stringa "1.234,50" e lo stato in codici numerici (3 = confermato). Il servizio Pagamenti definisce OrdineDaPagare(id: OrdineId, importo: Decimal, confermato: bool). L'ACL legge dal monolite via API interna, converte la stringa in Decimal("1234.50"), mappa 3 su True, e restituisce l'oggetto pulito. Quando Ordini diventa un servizio nuovo con JSON moderno, si riscrive solo l'Adapter.
Pattern correlati: Strangler Fig, Decompose by Subdomain, Adapter, Facade
Branch by Abstraction
In una frase: Sostituisci un componente dentro il codice mettendo prima un'interfaccia davanti, poi scambiando l'implementazione sotto, senza branch Git lunghi.
Problema che risolve: Devi sostituire la libreria di invio email, o il repository che legge dal vecchio database, in tutto il codice. Farlo in un branch separato per tre settimane significa conflitti continui e nessun rilascio. Serve un modo per fare il cambiamento a piccoli passi sul ramo principale, con il sistema sempre funzionante.
Come funziona:
flowchart LR
    mail["✉️ Servizio Notifiche"] -->|"invia()"| iface["🔌 Interfaccia Notificatore"]
    iface --> flag{{"🚩 Feature flag"}}
    flag -->|"off"| smtp["📮 SMTP vecchio"]
    flag -->|"on"| prov>"☁️ API provider nuovo"]
flowchart TD
subgraph passo1["Passo 1 - crea l'astrazione"]
c1["Codice chiamante"] --> i1["Interfaccia Notificatore"]
i1 --> v1["Implementazione vecchia - SMTP"]
end
subgraph passo2["Passo 2 - nuova implementazione dietro flag"]
c2["Codice chiamante"] --> i2["Interfaccia Notificatore"]
i2 -- "flag off" --> v2["Vecchia - SMTP"]
i2 -- "flag on" --> n2["Nuova - API provider"]
end
subgraph passo3["Passo 3 - rimuovi la vecchia"]
c3["Codice chiamante"] --> i3["Interfaccia Notificatore"]
i3 --> n3["Nuova - API provider"]
end- Introduci un'interfaccia (
Notificatore) e fai passare tutti i chiamanti da lì. La vecchia implementazione resta l'unica. Rilascia. - Scrivi la nuova implementazione dietro la stessa interfaccia. Un feature flag decide quale usare. Rilascia con flag spento.
- Accendi il flag per un gruppo di utenti, poi per tutti. Se qualcosa va male, spegni il flag.
- Elimina la vecchia implementazione e il flag. Spesso si elimina anche l'interfaccia, se non serve più.
Quando usarlo: - Il cambiamento tocca molti punti del codice e richiederebbe giorni o settimane. - Vuoi rilasciare ogni giorno anche durante la sostituzione (trunk-based development). - Il componente da sostituire ha un confine chiaro o se ne può creare uno.
Quando NON usarlo / rischi: - Il cambiamento è piccolo: fallo direttamente. - Dimenticare il passo 4: restano due implementazioni e un flag per sempre. - L'interfaccia viene disegnata sulla vecchia implementazione e vincola la nuova a imitarla.
Esempio pratico:
from typing import Protocol

class Notificatore(Protocol):
    def invia(self, destinatario: str, testo: str) -> None: ...

class NotificatoreSmtp:
    def invia(self, destinatario: str, testo: str) -> None:
        ...  # implementazione vecchia

class NotificatoreProvider:
    def invia(self, destinatario: str, testo: str) -> None:
        ...  # nuova API del provider

def crea_notificatore(flag_nuovo_provider: bool) -> Notificatore:
    if flag_nuovo_provider:
        return NotificatoreProvider()
    return NotificatoreSmtp()
Il servizio Notifiche usa solo Notificatore. Il flag si accende dalla configurazione, prima per il 5% dei clienti, poi per tutti.
Pattern correlati: Strangler Fig, Parallel Run, Feature Toggle, Strategy
Parallel Run
In una frase: Esegui il sistema vecchio e il nuovo sulla stessa richiesta, usa il risultato del vecchio e confronta quello del nuovo.
Problema che risolve: Il nuovo servizio Pagamenti calcola importi, sconti, tasse. I test passano, ma i casi reali sono migliaia e nessuno è sicuro che il nuovo calcolo coincida sempre con il vecchio. Un errore in produzione costa soldi veri. Serve una prova sul traffico reale senza rischiare.
Come funziona:
flowchart LR
    cliente(["🧑 Cliente"]) -->|"calcola totale"| router["🚦 Router"]
    router --> old["🏚️ Pagamenti vecchio"]
    router --> new["💳 Pagamenti nuovo"]
    old -->|"risposta usata"| cliente
    old -->|"123.50"| cmp["⚖️ Comparatore"]
    new -->|"123.50"| cmp
    cmp --> rep[/"📋 Report differenze"/]
sequenceDiagram
participant C as Client
participant R as Router
participant V as Pagamenti vecchio
participant N as Pagamenti nuovo
participant K as Comparatore
C->>R: calcola totale ordine
R->>V: calcola totale
R->>N: calcola totale
V-->>R: 123.50
N-->>R: 123.50
R-->>C: 123.50 (risposta del vecchio)
R->>K: vecchio 123.50 / nuovo 123.50
K->>K: registra uguale o diverso- Il router riceve la richiesta e la manda a entrambi i sistemi.
- Al client torna sempre la risposta del vecchio, che è quello di cui ci si fida.
- La risposta del nuovo viene confrontata con quella del vecchio e registrata.
- Dopo giorni o settimane si guardano le differenze: ogni differenza è un bug nel nuovo o nel vecchio.
- Quando le differenze sono zero (o spiegate), si inverte: il nuovo risponde e il vecchio si spegne.
Quando usarlo: - Il risultato è critico: soldi, tasse, dati legali. - La funzione è deterministica o quasi: stesso input, stesso output atteso. - Hai un volume di traffico reale sufficiente a coprire i casi strani.
Quando NON usarlo / rischi: - L'operazione ha effetti collaterali (addebita una carta, invia un'email): eseguirla due volte è un danno. Serve isolare la parte di calcolo. - Raddoppia il carico e il costo per tutta la durata del confronto. - Le differenze legittime (orari, arrotondamenti, dati in movimento) fanno rumore e nascondono i bug veri.
Esempio pratico: Il nuovo servizio Pagamenti deve calcolare il totale con IVA e sconti. Per tre settimane ogni richiesta calcola_totale va a entrambi. Il comparatore trova 40 differenze su 200.000: tutte ordini con coupon cumulativi, che il nuovo arrotondava per difetto. Si corregge, si aspetta un'altra settimana a zero differenze, poi il nuovo diventa quello che risponde. L'addebito vero sulla carta resta fuori dal parallel run: lo fa solo il vecchio.
Pattern correlati: Strangler Fig, Branch by Abstraction, Canary Release
Sidecar
In una frase: Un container affiancato al servizio, nello stesso pod, che si occupa di compiti trasversali come log, TLS e proxy.
Problema che risolve: Ogni servizio deve raccogliere log, cifrare il traffico, esporre metriche, ritentare le chiamate. Se Ordini è in Python, Pagamenti in Java e Catalogo in Go, la stessa logica va scritta tre volte e tenuta allineata. Serve un modo per dare queste funzioni a tutti senza toccare il codice di nessuno.
Come funziona:
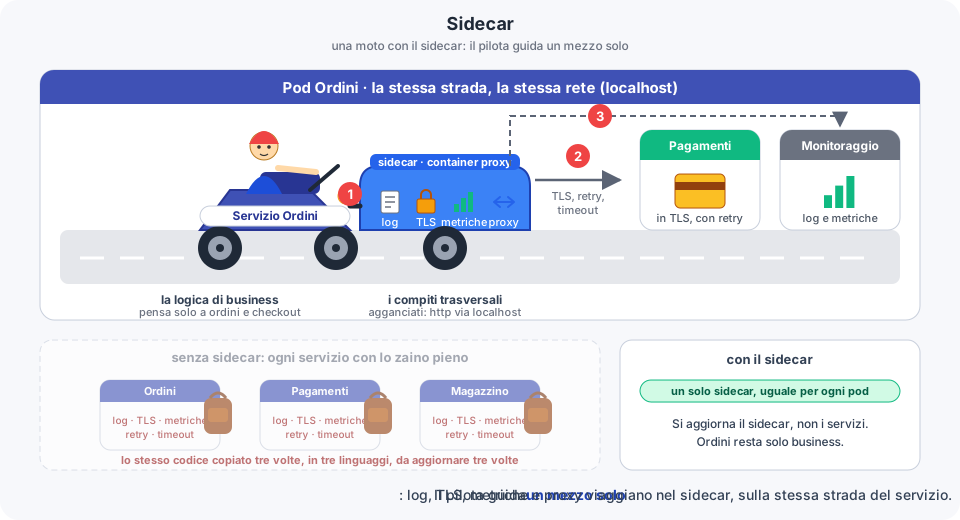
flowchart LR
    subgraph pod["Pod Servizio Ordini"]
        app["Container Ordini - Python"]
        side["Container Sidecar - proxy"]
        app <-- "localhost" --> side
    end
    side -- "TLS, retry, metriche" --> pag["Servizio Pagamenti"]
    side -- "log" --> logs["Raccolta log"]
side -- "metriche" --> mon["Monitoraggio"]- Il servizio Ordini e il sidecar vivono nello stesso pod: condividono rete e dischi, quindi parlano via
localhost. - Ordini manda richieste HTTP semplici al sidecar; il sidecar aggiunge TLS, retry, timeout e le inoltra a Pagamenti.
- Il sidecar legge i log dell'applicazione e li spedisce al sistema centrale; espone le metriche.
- Il sidecar è lo stesso per tutti i servizi, in qualsiasi linguaggio: si aggiorna una volta e vale per tutti.
Quando usarlo: - Servizi in linguaggi diversi che hanno bisogno delle stesse funzioni trasversali. - Vuoi aggiornare la logica di rete o di log senza rilasciare i servizi. - Usi un orchestratore (Kubernetes) che rende naturale il concetto di pod.
Quando NON usarlo / rischi: - Hai pochi servizi, tutti nello stesso linguaggio: una libreria è più semplice. - Ogni sidecar consuma CPU e memoria: con centinaia di pod il costo è visibile. - Aggiunge un salto di rete per ogni chiamata e un componente in più da debuggare quando qualcosa non risponde.
Esempio pratico: Nel cluster dell'e-commerce ogni pod ha un sidecar Envoy. Il servizio Ordini chiama http://localhost:15001/pagamenti/autorizza in chiaro; Envoy cifra con mTLS, ritenta una volta su errore di rete e registra la latenza. Il team piattaforma aggiorna la versione di TLS cambiando l'immagine del sidecar, senza che il team Ordini rilasci nulla.
Pattern correlati: Ambassador, Service Mesh, Circuit Breaker, Log Aggregation
Ambassador
In una frase: Un proxy affiancato al servizio che gestisce tutte le chiamate in uscita verso l'esterno: routing, autenticazione, retry.
Problema che risolve: Il servizio Pagamenti chiama un gateway di pagamento esterno, con certificati client, chiavi API a rotazione, un endpoint di produzione e uno di test. Tutta questa logica finisce nel codice di business e va replicata in ogni servizio che parla con l'esterno. Serve un "ambasciatore" che rappresenti il servizio verso fuori.
Come funziona:
flowchart LR
    subgraph pod["📦 Pod Pagamenti"]
        app["💳 Pagamenti"] -->|"http localhost"| amb["🤝 Ambassador"]
    end
    secret[/"🔑 Secret: chiave API, certificato"/] --> amb
    amb -->|"mTLS + X-Api-Key"| gw>"☁️ Gateway pagamenti esterno"]
    amb -.->|"in ambiente test"| sandbox>"🧪 Sandbox del gateway"]
flowchart LR
subgraph pod["Pod Servizio Pagamenti"]
app["Pagamenti"] -- "http localhost" --> amb["Ambassador"]
end
amb -- "mTLS, chiave API, retry" --> gw["Gateway pagamenti esterno"]
amb -. "in ambiente test" .-> sandbox["Sandbox del gateway"]- Pagamenti chiama sempre
localhost: non sa nulla di certificati, chiavi, URL esterni. - L'Ambassador aggiunge le credenziali, apre la connessione cifrata e gestisce retry e timeout.
- In ambiente di test l'Ambassador punta alla sandbox: il codice di Pagamenti è identico.
- È un caso particolare di Sidecar specializzato nel traffico in uscita.
Quando usarlo: - Il servizio parla con sistemi esterni con autenticazione complessa o che cambia spesso. - Vuoi cambiare destinazione (test, produzione, fornitore nuovo) senza toccare il codice. - Un servizio legacy non sa fare TLS moderno o retry, e non puoi modificarlo.
Quando NON usarlo / rischi: - Il servizio fa una sola chiamata esterna semplice: una libreria HTTP basta. - Stesso costo del sidecar: risorse e un salto di rete in più. - Se l'Ambassador nasconde gli errori (retry infiniti), il servizio non si accorge che l'esterno è giù.
Esempio pratico: Il servizio Pagamenti chiama http://localhost:8081/autorizza. L'Ambassador conosce il certificato client, aggiunge l'header X-Api-Key letto da un secret, e inoltra a https://api.gateway-pagamenti.example/v2/authorize. Quando l'azienda cambia fornitore, si riconfigura l'Ambassador e si adatta solo il formato della richiesta.
Pattern correlati: Sidecar, Service Mesh, Anti-Corruption Layer, Retry, Proxy
Service Mesh
In una frase: Un'infrastruttura (Istio, Linkerd) che mette un sidecar proxy accanto a ogni servizio e li governa da un piano di controllo centrale.
Problema che risolve: Con cinque servizi i sidecar si configurano a mano. Con cinquanta, ogni cambio di policy (mTLS obbligatorio, timeout, routing del 10% del traffico alla nuova versione) va ripetuto ovunque. Serve un posto unico dove dire "tutte le chiamate fra servizi sono cifrate" e che valga subito per tutti.
Come funziona:
flowchart TD
    cp["🎛️ Control plane Linkerd"]
    cp -->|"policy mTLS"| p1["🛵 Proxy"]
    cp -->|"policy mTLS"| p2["🛵 Proxy"]
    cp -->|"policy mTLS"| p3["🛵 Proxy"]
    p1 --- ord["📦 Ordini"]
    p2 --- pay["💳 Pagamenti"]
    p3 --- mag["🏭 Magazzino"]
    p1 -->|"cifrato"| p2
    p1 -->|"cifrato"| p3
flowchart TD
cp["Control plane - Istio / Linkerd"]
cp -- "configura" --> p1["Proxy"]
cp -- "configura" --> p2["Proxy"]
cp -- "configura" --> p3["Proxy"]
subgraph podOrd["Pod Ordini"]
ord["Ordini"] <--> p1
end
subgraph podPag["Pod Pagamenti"]
pag["Pagamenti"] <--> p2
end
subgraph podMag["Pod Magazzino"]
mag["Magazzino"] <--> p3
end
p1 -- "mTLS" --> p2
p1 -- "mTLS" --> p3- Il data plane è l'insieme dei proxy sidecar: ogni chiamata fra servizi passa per due proxy, uno in uscita e uno in ingresso.
- Il control plane distribuisce ai proxy certificati, regole di routing, timeout, retry e policy di accesso.
- Il codice dei servizi non cambia: Ordini chiama
http://pagamenti/autorizzae la mesh fa il resto. - La mesh sposta fuori dal codice: mTLS, retry e timeout, Circuit Breaker, tracing distribuito, canary routing, autorizzazione fra servizi.
Quando usarlo: - Decine di servizi su Kubernetes e serve mTLS, osservabilità e routing uniformi. - Più team e più linguaggi: le policy devono valere per tutti senza librerie. - Requisiti di sicurezza (zero trust) che impongono cifratura e identità su ogni chiamata.
Quando NON usarlo / rischi: - Pochi servizi: la mesh è più complessa dell'applicazione che protegge. - Curva di apprendimento alta e debug difficile: un errore di configurazione della mesh ferma tutto. - Latenza e consumo aggiuntivi su ogni chiamata, moltiplicati per due proxy.
Esempio pratico: L'e-commerce ha 30 servizi. Il team piattaforma installa Linkerd. Con una regola si attiva mTLS fra tutti i servizi. Per rilasciare la versione 2 di Pagamenti si scrive una policy che manda il 10% del traffico alla nuova versione e si osservano errori e latenza nella dashboard della mesh, senza toccare né Ordini né Pagamenti.
Pattern correlati: Sidecar, Ambassador, Circuit Breaker, Distributed Tracing, Canary Release
Self-contained Service vs Shared Library
In una frase: Un servizio deve avere tutto ciò che gli serve per essere rilasciato da solo; una libreria condivisa con logica di business è un accoppiamento nascosto.
Problema che risolve: Per non duplicare codice, i team creano ecommerce-common con modelli, validazioni e client condivisi. Dopo un anno ogni modifica alla libreria richiede di rilasciare tutti i servizi insieme, e un bug nella libreria li rompe tutti. Il monolite è tornato, solo distribuito su più repository.
Come funziona:
flowchart LR
    subgraph male["🚫 Accoppiamento nascosto"]
        lib["📦 ecommerce-common - Ordine, calcola_sconto"] -->|"rilascio insieme"| o1["📦 Ordini"]
        lib -->|"rilascio insieme"| m1["🏭 Magazzino"]
    end
    subgraph bene["✅ Servizi autonomi"]
        o2["📦 Ordini - proprio Ordine"] -->|"chiama API calcola_sconto"| cat["🛍️ Catalogo"]
        util["🧰 Libreria tecnica - log, http"] -.-> o2
    end
flowchart LR
subgraph male["Accoppiamento nascosto"]
lib["Libreria common - modelli e regole"]
lib --> o1["Ordini"]
lib --> p1["Pagamenti"]
lib --> m1["Magazzino"]
end
subgraph bene["Servizi autonomi"]
o2["Ordini - proprio modello"]
p2["Pagamenti - proprio modello"]
m2["Magazzino - proprio modello"]
util["Libreria tecnica - log, tracing, client HTTP"]
util -.-> o2
util -.-> p2
util -.-> m2
end- A sinistra la libreria contiene il modello
Ordinee le regole di sconto: se cambia una regola, cambia la libreria, e tutti i servizi devono aggiornarla e rilasciare insieme. - A destra ogni servizio ha il suo modello, anche se somiglia a quello degli altri: la duplicazione è accettata perché i modelli evolveranno in direzioni diverse.
- Si condivide solo codice tecnico e stabile: log, tracing, client HTTP, autenticazione. Mai regole di business.
- Regola pratica: se una modifica alla libreria obbliga a rilasciare più servizi insieme, la libreria contiene qualcosa che non dovrebbe.
Quando usarlo: - Scegli il servizio autonomo quando il codice in questione è logica di dominio o un modello dati. - Scegli la libreria condivisa per codice tecnico, stabile e senza conoscenza del dominio. - Quando due servizi condividono una regola di business, chiediti se uno dei due dovrebbe esporla come API.
Quando NON usarlo / rischi: - La duplicazione portata all'estremo: dieci copie di una stessa validazione fiscale che devono cambiare nello stesso giorno per legge. - Libreria tecnica con versioni incompatibili fra servizi: serve una politica di versionamento chiara. - Il "modello condiviso" nei contratti (eventi, DTO): va versionato come API pubblica, non importato come classe.
Esempio pratico: ecommerce-common conteneva Prodotto, Ordine e calcola_sconto. Il team Ordini doveva aggiungere un campo a Ordine ma Magazzino non compilava più. Si decide: Prodotto e Ordine vanno in ogni servizio con solo i campi che gli servono; calcola_sconto diventa un endpoint del servizio Catalogo; in ecommerce-common restano solo il client HTTP con tracing e il formato dei log.
Pattern correlati: Decompose by Subdomain, Database per Service, Anti-pattern da riconoscere
Anti-pattern da riconoscere
Distributed Monolith. Servizi separati che devono essere rilasciati insieme perché condividono database, librerie di business o chiamate sincrone a catena. Hai tutti i costi dei microservizi e nessun beneficio. Segnale: un rilascio di Ordini richiede di coordinare e rilasciare anche Pagamenti e Magazzino nello stesso giorno.
Nano-services. Servizi così piccoli che il costo di rete, rilascio e monitoraggio supera il valore della funzione che contengono. Una funzione per servizio non è un'architettura, è frammentazione. Segnale: per completare un ordine servono dieci chiamate a dieci servizi, e nessuno sa quale servizio possiede il concetto "ordine".
Shared Database. Più servizi leggono e scrivono le stesse tabelle. Ogni cambio di schema spaventa tutti, e nessuno può cambiare tecnologia di storage.
Segnale: una migrazione sulla tabella ordini richiede l'approvazione di tre team, o un servizio legge direttamente dalla tabella di un altro.
Chatty services. Due servizi che si scambiano decine di chiamate sincrone per completare una sola operazione. Il confine fra i due è nel posto sbagliato: in realtà sono una cosa sola. Segnale: il tracing mostra che una richiesta "mostra carrello" produce 40 chiamate fra Ordini e Catalogo, e la latenza totale è la somma di tutte.
Come scegliere
flowchart TD
    q1{"Hai gia un monolite in produzione da migrare?"}
    q1 -- No --> q2{"Il dominio e complesso con termini ambigui?"}
    q2 -- Si --> subdomain["Decompose by Subdomain"]
    q2 -- No --> q3{"Le funzioni di business sono chiare e stabili?"}
    q3 -- Si --> capability["Decompose by Business Capability"]
    q3 -- No --> modular["Resta su un monolite modulare"]
    q1 -- Si --> q4{"Il cambiamento e dentro un solo codebase?"}
    q4 -- Si --> bba["Branch by Abstraction"]
    q4 -- No --> strangler["Strangler Fig"]
    strangler --> q5{"Il nuovo deve parlare con il legacy?"}
    q5 -- Si --> acl["Anti-Corruption Layer"]
    strangler --> q6{"Il risultato e critico e deve coincidere?"}
    q6 -- Si --> parallel["Parallel Run"]
    q7{"Serve logica trasversale fuori dal codice?"}
    q7 -- "Pochi servizi, in uscita verso esterni" --> ambassador["Ambassador"]
    q7 -- "Pochi servizi, log TLS metriche" --> sidecar["Sidecar"]
    q7 -- "Decine di servizi" --> mesh["Service Mesh"]
Regola veloce: se non hai un monolite, scegli come tagliare (sottodominio o capacità) e valuta se il monolite modulare basta. Se hai un monolite, Strangler Fig è il percorso, con Anti-Corruption Layer e Parallel Run come protezioni. Sidecar, Ambassador e Service Mesh rispondono a una domanda diversa: quanta infrastruttura trasversale spostare fuori dal codice, in base al numero di servizi.