Pattern per dati e transazioni distribuite
Ogni microservizio ha i suoi dati. Questo rende i servizi indipendenti, ma crea un problema nuovo: una operazione di business tocca spesso più servizi, e non esiste una transazione unica che li copra tutti. I pattern di questa categoria servono a tenere i dati coerenti senza rinunciare all'autonomia dei servizi.
flowchart TD
    subgraph dati["🗄️ Chi possiede i dati"]
        dbps["Database per Service"]
    end
    subgraph eventi["📨 Pubblicare eventi senza perderli"]
        outbox["Transactional Outbox"]
        cdc["Transaction Log Tailing / CDC"]
        idem["Idempotent Consumer"]
    end
    subgraph tx["🔁 Operazioni su più servizi"]
        chor["Saga Coreografia"]
        orch["Saga Orchestrazione"]
        tpc["Two-Phase Commit (solo riferimento)"]
    end
    subgraph lettura["🔍 Letture e storia"]
        cqrs["CQRS"]
        es["Event Sourcing"]
    end
    dbps --> eventi
    eventi --> tx
tx --> lettura| Pattern | Problema che risolve | Usalo quando |
|---|---|---|
| Database per Service | Servizi accoppiati dallo stesso schema del database | Vuoi rilasciare e scalare ogni servizio in modo indipendente |
| Transactional Outbox | Scrivere sul DB e pubblicare un evento in modo atomico | Un servizio deve notificare gli altri in modo affidabile |
| Idempotent Consumer | Lo stesso messaggio arriva due volte e viene elaborato due volte | Usi un broker con consegna at-least-once |
| Saga Coreografia | Transazione di business su più servizi, senza coordinatore | Pochi servizi coinvolti, flusso semplice, team autonomi |
| Saga Orchestrazione | Transazione di business su più servizi, con flusso esplicito | Flusso con molti passi, serve vedere lo stato in un punto solo |
| CQRS | Un solo modello serve male sia scritture che letture | Letture complesse o molto più frequenti delle scritture |
| Event Sourcing | Perdi la storia dei cambiamenti dello stato | Serve audit completo, replay o ricostruzione dello stato |
| Transaction Log Tailing CDC | Pubblicare i cambiamenti del DB senza polling | Hai Debezium o simile e vuoi latenza bassa |
| Two-Phase Commit | Commit atomico su più database | Quasi mai nei microservizi, solo in sistemi monolitici o legacy |
Il problema di fondo
In un monolite una operazione come "crea ordine, scala il magazzino, addebita il pagamento" sta dentro una sola transazione ACID. Se un passo fallisce, il database annulla tutto. Nei microservizi ogni servizio ha il suo database, e nessuna transazione copre più servizi insieme. La coerenza non è più un regalo del database: va costruita.
Il caso più comune in cui si rompe la coerenza è il dual write: un servizio scrive sul suo database e poi pubblica un evento sul broker. Sono due sistemi diversi, quindi due scritture separate. Se la seconda fallisce, il database dice una cosa e il resto del sistema ne sa un'altra.
sequenceDiagram
    participant O as Servizio Ordini
    participant DB as Database Ordini
    participant B as Broker
    participant P as Servizio Pagamenti
    O->>DB: INSERT ordine 42
    DB-->>O: ok
    O--xB: publish OrdineCreato 42
    Note over O,B: il broker non risponde o il servizio va giù
    Note over P: Pagamenti non riceve nulla
    Note over DB,P: ordine 42 esiste ma nessuno lo paga
Invertire l'ordine non aiuta: se pubblichi prima e poi la scrittura sul database fallisce, gli altri servizi reagiscono a un ordine che non esiste. I pattern che seguono risolvono questo problema in modi diversi, con compromessi diversi fra semplicità, latenza e garanzie.
Database per Service
In una frase: ogni servizio possiede il suo database e nessun altro servizio ci accede direttamente.
Problema che risolve: se due servizi leggono e scrivono le stesse tabelle, ogni cambio di schema richiede di coordinare due team e due rilasci. Un servizio con una query lenta rallenta anche l'altro. Nei fatti i due servizi sono un monolite distribuito.
Come funziona:
flowchart LR
    ordini["📦 Servizio Ordini"] -->|"mio"| dbO[("🗄️ DB Ordini")]
    catalogo["🏷️ Servizio Catalogo"] -->|"mio"| dbC[("🗄️ DB Catalogo")]
    ordini -->|"chiedi prezzo via API"| catalogo
    ordini -.->|"🚫 VIETATO"| dbC
flowchart LR
svcOrdini["Servizio Ordini"] --> dbOrdini[("DB Ordini")]
svcPagamenti["Servizio Pagamenti"] --> dbPagamenti[("DB Pagamenti")]
svcMagazzino["Servizio Magazzino"] --> dbMagazzino[("DB Magazzino")]
svcOrdini -- "API o eventi" --> svcPagamenti
svcOrdini -- "API o eventi" --> svcMagazzinoOgni servizio ha un suo schema, un suo database o almeno tabelle private. Il servizio Ordini non legge la tabella stock del Magazzino: chiede al servizio Magazzino tramite API, oppure ascolta i suoi eventi e tiene una copia locale dei dati che gli servono. Il database può essere anche di tipo diverso: Catalogo può usare un database documentale, Pagamenti uno relazionale.
Quando usarlo: - Vuoi rilasciare un servizio senza coordinare lo schema con altri team. - I servizi hanno esigenze di scalabilità o di tipo di dato diverse. - È il punto di partenza di quasi tutti gli altri pattern di questo file.
Quando NON usarlo / rischi:
- L'anti-pattern opposto è lo Shared Database: un solo database condiviso da tutti i servizi. Sembra comodo, perché hai transazioni ACID e join fra tabelle, ma accoppia i servizi in modo nascosto. Un ALTER TABLE può rompere un servizio che non conosci. È accettabile solo come passo temporaneo durante una migrazione da monolite.
- Le query che univano tabelle di più domini diventano chiamate di rete o proiezioni (vedi CQRS).
- Le transazioni fra servizi non esistono più: servono Saga e Transactional Outbox.
Esempio pratico: il servizio Catalogo tiene i prodotti con descrizione e prezzo in un database documentale. Il servizio Ordini, quando crea un ordine, salva una copia di nome e prezzo del prodotto nella riga dell'ordine. Se Catalogo cambia il prezzo domani, l'ordine di ieri resta corretto, e Ordini non ha bisogno di leggere il database di Catalogo.
Pattern correlati: Transactional Outbox, Saga Coreografia, CQRS, Strangler Fig.
Transactional Outbox
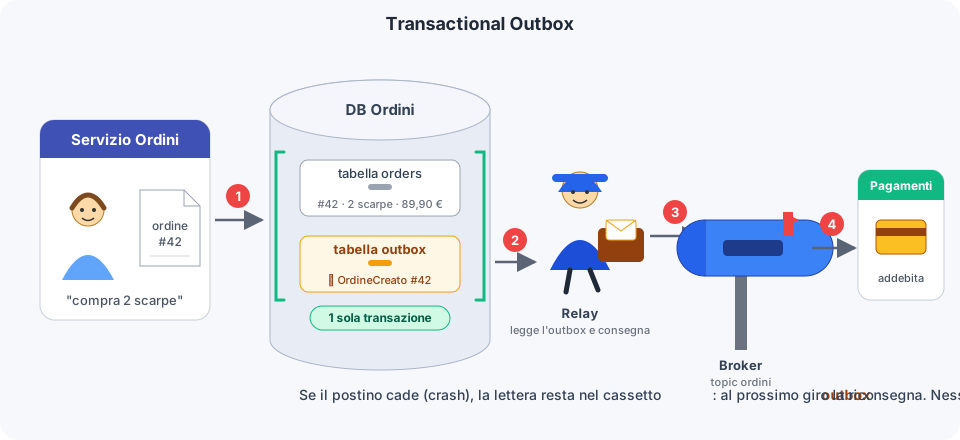
In una frase: salva l'evento nella stessa transazione del dato, in una tabella outbox, e un processo separato lo pubblica sul broker.
Problema che risolve: il dual write descritto sopra. Il servizio deve scrivere sul database e pubblicare un evento, ma non può farlo in modo atomico. Con l'outbox la pubblicazione diventa una conseguenza della scrittura, non una seconda operazione che può fallire da sola.
Come funziona:
sequenceDiagram
    participant O as Servizio Ordini
    participant DB as Database Ordini
    participant R as Relay
    participant B as Broker
    participant P as Servizio Pagamenti
    O->>DB: BEGIN
    O->>DB: INSERT ordini (42)
    O->>DB: INSERT outbox (OrdineCreato 42)
    O->>DB: COMMIT
    loop ogni N ms o via CDC
        R->>DB: leggi righe outbox non pubblicate
        DB-->>R: OrdineCreato 42
        R->>B: publish OrdineCreato 42
        B-->>R: ack
        R->>DB: marca come pubblicata o cancella
    end
B->>P: OrdineCreato 42- Il servizio apre una transazione, scrive l'ordine e scrive una riga nella tabella
outboxcon il payload dell'evento. Il commit è unico: o ci sono entrambe le righe, o nessuna. - Un componente chiamato relay (o message relay) legge le righe dell'outbox e le pubblica sul broker.
- Dopo l'ack del broker, il relay marca la riga come pubblicata o la cancella.
- Se il relay muore fra la pubblicazione e la marcatura, al riavvio ripubblica lo stesso evento. La consegna è quindi at-least-once: i consumatori devono essere idempotenti.
Il relay ha due varianti:
- Polling publisher: un processo interroga la tabella
outboxa intervalli regolari (SELECT ... WHERE published = false ORDER BY id LIMIT 100). Semplice da scrivere, funziona con qualsiasi database. Il costo è una latenza pari all'intervallo di polling e un carico costante sul database. - Transaction log tailing (CDC): uno strumento come Debezium legge il log delle transazioni del database (WAL di PostgreSQL, binlog di MySQL) e trasforma ogni
INSERTnella tabellaoutboxin un messaggio Kafka. Latenza di millisecondi, nessun carico di polling, ma serve configurare il database e un componente in più. È descritto come pattern a sé in Transaction Log Tailing / CDC.
Quando usarlo: - Ogni volta che un servizio scrive un dato e deve pubblicare un evento su quel dato. - Hai un database relazionale o comunque con transazioni locali. - Vuoi garanzie di consegna senza un broker transazionale.
Quando NON usarlo / rischi:
- La tabella outbox cresce: serve una pulizia periodica delle righe pubblicate.
- L'ordine degli eventi è garantito solo per righe dello stesso aggregato se il relay rispetta l'ordine di inserimento e usa la stessa partizione del broker.
- Non serve se il tuo database è lo stesso broker (per esempio usi solo un event store), o se il dato e l'evento vivono già nello stesso sistema.
- La consegna duplicata è possibile: senza Idempotent Consumer il pattern è incompleto.
Esempio pratico: il servizio Ordini riceve POST /ordini. In una sola transazione inserisce la riga in ordini e una riga in outbox con {"tipo": "OrdineCreato", "ordine_id": 42, "totale": 99.90}. Debezium legge il WAL, pubblica il messaggio sul topic ordini.eventi. Pagamenti lo riceve e avvia l'addebito. Se il broker era giù per dieci minuti, la riga resta in outbox e viene pubblicata quando il broker torna: nessun ordine perso.
Pattern correlati: Idempotent Consumer, Transaction Log Tailing / CDC, Saga Coreografia, Messaggistica asincrona.
Idempotent Consumer
In una frase: il consumatore riconosce i messaggi già elaborati tramite il loro id e li ignora.
Problema che risolve: i broker e l'outbox consegnano i messaggi almeno una volta. Dopo un riavvio o un timeout, lo stesso evento OrdineCreato 42 può arrivare due volte. Senza protezione, Pagamenti addebita il cliente due volte.
Come funziona:
flowchart LR
    coda[["📨 Broker"]]
    m1["✉️ OrdineCreato 42, id 9871"]
    m2["✉️ OrdineCreato 42, id 9871 (copia)"]
    pay["💳 Pagamenti"]
    reg[("📒 processed_messages")]
    carta["💶 Addebito una volta"]
    cestino["🗑️ Scartato"]
    coda --> m1 --> pay
    coda --> m2 --> pay
    pay -->|"id 9871 visto?"| reg
    pay -->|"no"| carta
    pay -->|"sì"| cestino
flowchart TD
msg["Messaggio con message_id"] --> check{"message_id già in processed_messages?"}
check -- "sì" --> skip["Ignora e manda ack"]
check -- "no" --> tx["BEGIN transazione"]
tx --> logic["Esegui la logica di business"]
logic --> save["INSERT message_id in processed_messages"]
save --> commit["COMMIT"]
commit --> ack["Manda ack al broker"]- Ogni messaggio porta un
message_idunivoco, assegnato dal produttore (per esempio l'id della rigaoutbox). - Il consumatore tiene una tabella
processed_messagesnel proprio database. - Prima di elaborare, controlla se l'id è già presente. Se sì, manda l'ack e non fa nulla.
- Se no, esegue la logica di business e inserisce l'id nella stessa transazione. Così, se il processo muore a metà, il messaggio non risulta elaborato e verrà ritentato.
Esiste una variante senza tabella: rendere la logica stessa idempotente, per esempio con UPSERT o con una chiave univoca sul dato (UNIQUE(ordine_id) sulla tabella pagamenti).
Quando usarlo: - Sempre, quando consumi messaggi da un broker con consegna at-least-once (Kafka, RabbitMQ, SQS). - Quando la logica ha effetti collaterali non ripetibili: addebiti, invio email, scalo di magazzino.
Quando NON usarlo / rischi:
- Se l'operazione è già idempotente per natura (per esempio SET stato = 'spedito'), la tabella di deduplica è un costo inutile.
- La tabella processed_messages cresce: serve una scadenza (per esempio tieni gli id degli ultimi 7 giorni).
- La deduplica funziona solo se il message_id è stabile: se il produttore rigenera l'id a ogni tentativo, il pattern non protegge.
Esempio pratico: Pagamenti riceve OrdineCreato con message_id = "outbox-9871". Controlla processed_messages, non lo trova, addebita 99.90 euro e inserisce l'id nella stessa transazione. Dopo trenta secondi il broker riconsegna lo stesso messaggio perché l'ack si è perso. Pagamenti trova l'id, manda l'ack e non addebita di nuovo.
Pattern correlati: Transactional Outbox, Retry, Messaggistica asincrona.
Saga — Coreografia
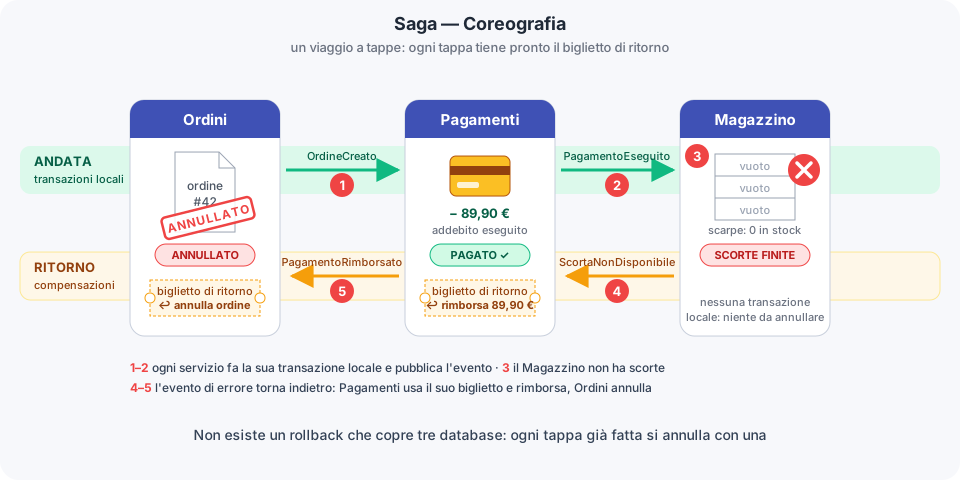
In una frase: una transazione di business su più servizi diventa una catena di transazioni locali, collegate da eventi, ognuna con una azione di compensazione.
Problema che risolve: creare un ordine richiede un passo in Ordini, uno in Pagamenti, uno in Magazzino. Non c'è una transazione che li copra. Se Magazzino non ha scorte, il pagamento già fatto va annullato. La saga definisce chi fa cosa e come si torna indietro.
Come funziona:
sequenceDiagram
    participant O as Servizio Ordini
    participant B as Broker
    participant P as Servizio Pagamenti
    participant M as Servizio Magazzino
    O->>B: OrdineCreato
    B->>P: OrdineCreato
    P->>P: addebita carta
    P->>B: PagamentoEseguito
    B->>M: PagamentoEseguito
    M->>M: scorte insufficienti
    M->>B: ScortaNonDisponibile
    B->>P: ScortaNonDisponibile
    P->>P: rimborsa carta (compensazione)
    P->>B: PagamentoRimborsato
    B->>O: ScortaNonDisponibile
O->>O: ordine ANNULLATO- Ordini crea l'ordine in stato
IN_ATTESAe pubblicaOrdineCreato. - Pagamenti ascolta, addebita la carta e pubblica
PagamentoEseguito. - Magazzino ascolta, prova a riservare le scorte. Nel caso felice pubblica
ScortaRiservatae Ordini porta l'ordine aCONFERMATO. - Nel caso di fallimento Magazzino pubblica
ScortaNonDisponibile. Pagamenti lo ascolta ed esegue la compensazione: il rimborso. Ordini lo ascolta e porta l'ordine adANNULLATO.
Non esiste un coordinatore: ogni servizio sa quali eventi ascoltare, cosa fare e cosa pubblicare. La compensazione non è un rollback: il pagamento è avvenuto e viene rimborsato, e i due movimenti restano entrambi nella storia.
Quando usarlo: - La saga ha 2-4 passi e il flusso è lineare. - I team vogliono massima autonomia e nessun componente centrale. - Già usi eventi fra i servizi.
Quando NON usarlo / rischi: - Con molti passi il flusso diventa invisibile: per capire cosa succede devi leggere il codice di tutti i servizi. Passa a Saga Orchestrazione. - Rischio di dipendenze cicliche fra servizi che si ascoltano a vicenda. - Difficile testare il flusso completo e difficile capire in che stato è una saga in corso. - Ogni passo richiede Transactional Outbox e Idempotent Consumer, altrimenti la catena si rompe.
Esempio pratico: un cliente ordina due paia di scarpe. Ordini pubblica OrdineCreato, Pagamenti addebita 180 euro, Magazzino scopre che resta un solo paio e pubblica ScortaNonDisponibile. Pagamenti rimborsa 180 euro, Ordini segna l'ordine come annullato, Notifiche manda al cliente l'email "ordine annullato, rimborso in corso".
Pattern correlati: Saga Orchestrazione, Transactional Outbox, Idempotent Consumer, Event-driven.
Saga — Orchestrazione
In una frase: un orchestratore centrale dice a ogni servizio cosa fare, passo per passo, e gestisce le compensazioni quando un passo fallisce.
Problema che risolve: quando la saga ha molti passi o percorsi alternativi, la coreografia diventa un groviglio di eventi. Serve un punto che conosca l'intero flusso, tenga lo stato della saga e decida cosa fare in caso di errore.
Come funziona:
flowchart TD
    orch["🎼 Orchestratore ordine"]
    stato[("📒 Stato saga")]
    pay["💳 Pagamenti"]
    mag["🏭 Magazzino"]
    mail["✉️ Notifiche"]
    orch -->|"salva passo"| stato
    orch -->|"1. AddebitaCarta"| pay
    orch -->|"2. RiservaScorta"| mag
    orch -->|"3. InviaConferma"| mail
    pay -->|"esito"| orch
    mag -->|"esito"| orch
stateDiagram-v2
[*] --> OrdineCreato
OrdineCreato --> PagamentoInCorso : comando AddebitaCarta
PagamentoInCorso --> ScortaInCorso : PagamentoEseguito
PagamentoInCorso --> Annullato : PagamentoRifiutato
ScortaInCorso --> Confermato : ScortaRiservata
ScortaInCorso --> RimborsoInCorso : ScortaNonDisponibile
RimborsoInCorso --> Annullato : PagamentoRimborsato
Confermato --> [*]
Annullato --> [*]- L'orchestratore (spesso vive dentro il servizio Ordini, oppure è un servizio a sé) crea una istanza di saga con stato
OrdineCreatoe la salva nel suo database. - Manda il comando
AddebitaCartaa Pagamenti e passa aPagamentoInCorso. - Alla risposta
PagamentoEseguitomandaRiservaScortaa Magazzino. - Se Magazzino risponde
ScortaNonDisponibile, l'orchestratore manda il comando di compensazioneRimborsaCartae poi porta la saga adAnnullato.
Lo stato della saga è un dato persistente: se l'orchestratore si riavvia, riprende da dove era. I servizi partecipanti non sanno nulla del flusso: ricevono un comando e rispondono con un evento.
| Coreografia | Orchestrazione | |
|---|---|---|
| Chi decide il prossimo passo | Ogni servizio, ascoltando eventi | L'orchestratore, mandando comandi |
| Accoppiamento | Basso, ma nascosto negli eventi | Esplicito verso l'orchestratore |
| Visibilità del flusso | Sparsa in più servizi | In un posto solo |
| Stato della saga | Nessuno lo conosce intero | Persistito nell'orchestratore |
| Complessità da aggiungere | Nessun componente nuovo | Un orchestratore da scrivere e gestire |
| Adatta a | 2-4 passi, flusso lineare | Molti passi, rami, timeout |
| Rischio principale | Dipendenze cicliche, debug difficile | L'orchestratore diventa un "cervello" che sa troppo |
Quando usarlo: - La saga ha più di 4 passi, rami condizionali o timeout. - Serve sapere in ogni momento in che stato è una saga (supporto clienti, dashboard). - Vuoi testare il flusso in un punto solo.
Quando NON usarlo / rischi: - L'orchestratore tende ad assorbire logica di business dei servizi: deve coordinare, non decidere il prezzo o lo sconto. - È un componente in più da rendere affidabile: se cade, le saghe si fermano. - Per saghe a due passi è più codice del necessario.
Esempio pratico: l'orchestratore ordine riceve OrdineCreato 42, manda AddebitaCarta a Pagamenti, poi RiservaScorta a Magazzino, poi InviaConferma a Notifiche. Se Magazzino risponde ScortaNonDisponibile dopo 2 secondi, manda RimborsaCarta e InviaAnnullamento. Il supporto clienti apre la dashboard, cerca l'ordine 42 e vede lo stato RimborsoInCorso con il timestamp di ogni passo.
Pattern correlati: Saga Coreografia, Transactional Outbox, Timeout, Command / State.
CQRS
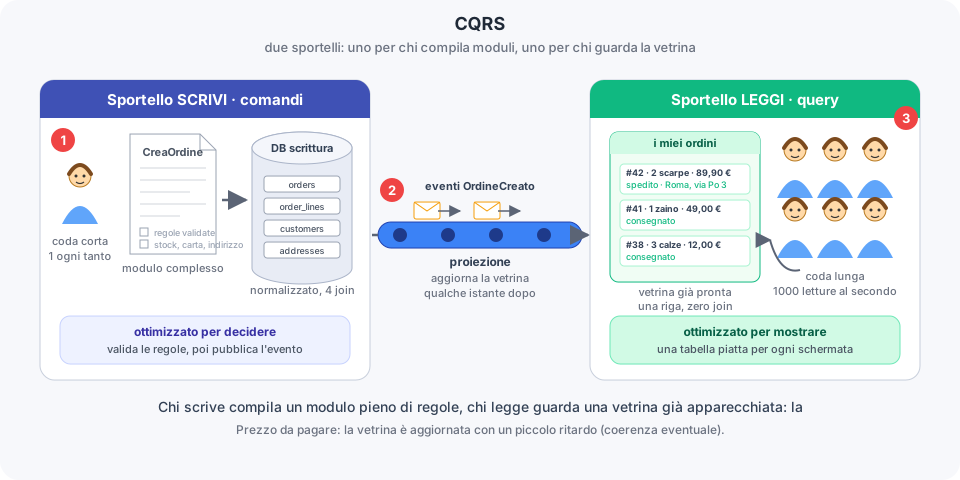
In una frase: separa il modello che gestisce le scritture (comandi) dal modello che serve le letture (query), aggiornando il secondo tramite eventi.
Problema che risolve: con un database per servizio, la pagina "i miei ordini con nome prodotto e stato spedizione" richiede dati di Ordini, Catalogo e Magazzino. Fare tre chiamate a ogni richiesta è lento e fragile. Inoltre lo stesso modello che valida gli ordini è spesso pessimo per fare ricerche e report.
Come funziona:
flowchart LR
    client["Client"] -- "comando CreaOrdine" --> write["Modello di scrittura Ordini"]
    write --> dbWrite[("DB scrittura")]
    write -- "OrdineCreato" --> broker["Broker"]
    catalogo["Servizio Catalogo"] -- "PrezzoAggiornato" --> broker
    broker --> proj["Proiezione"]
    proj --> dbRead[("DB lettura denormalizzato")]
    client -- "query StoricoOrdini" --> read["Modello di lettura"]
read --> dbRead- I comandi (
CreaOrdine,AnnullaOrdine) vanno al modello di scrittura, che valida le regole e salva nel suo database. - Il modello di scrittura pubblica eventi (tramite Transactional Outbox).
- Una proiezione ascolta gli eventi di uno o più servizi e aggiorna un database di lettura già nella forma che serve alla query: una tabella piatta
storico_ordinicon nome prodotto, prezzo, stato spedizione. - Le query leggono solo da questo database. Nessun join a runtime, nessuna chiamata ad altri servizi.
Il database di lettura è eventualmente coerente: fra la scrittura e l'aggiornamento della proiezione passano millisecondi o secondi.
Quando usarlo: - Le letture sono molto più frequenti delle scritture e hanno forme diverse (liste, ricerche, report). - Una vista ha bisogno di dati di più servizi. - Vuoi scalare le letture separatamente, per esempio con repliche o un motore di ricerca.
Quando NON usarlo / rischi: - Per un CRUD semplice raddoppia il codice senza benefici. - L'utente può non vedere subito quello che ha appena scritto ("ho creato l'ordine ma la lista è vuota"): serve gestirlo nell'interfaccia. - Ogni proiezione è codice da mantenere e da poter ricostruire da zero quando cambia.
Esempio pratico: la pagina "i miei ordini" legge da una tabella vista_ordini_cliente con colonne ordine_id, data, nome_prodotto, prezzo, stato_spedizione. La proiezione la aggiorna quando riceve OrdineCreato da Ordini e SpedizioneAvviata da Magazzino. Una query, una tabella, risposta in pochi millisecondi anche con milioni di ordini.
Pattern correlati: Event Sourcing, Database per Service, Transactional Outbox, API Composition.
Event Sourcing
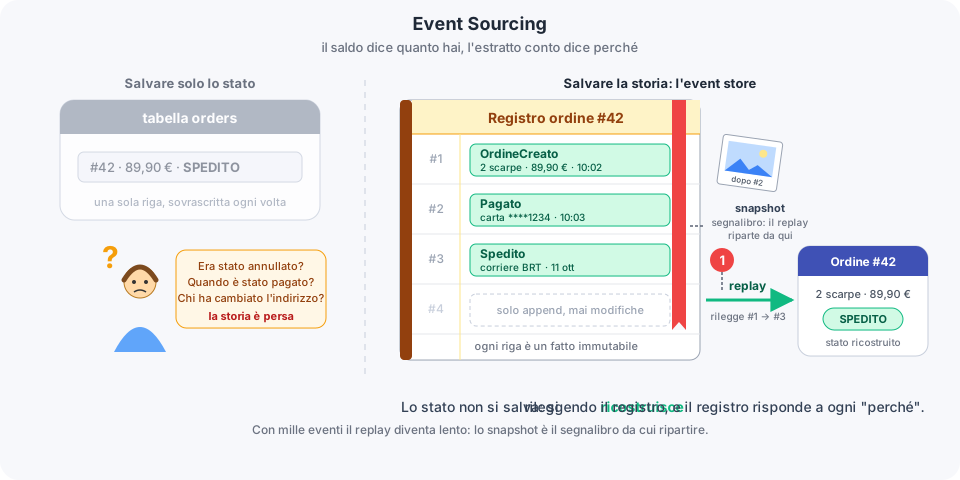
In una frase: invece di salvare lo stato corrente, salva la sequenza di eventi che lo hanno prodotto e ricostruisci lo stato rileggendoli.
Problema che risolve: con una tabella ordini che ha una colonna stato, sai che l'ordine è ANNULLATO ma non sai quando, perché e cosa è successo prima. Per audit, contestazioni e analisi la storia conta più dello stato finale. In più, salvare lo stato e pubblicare eventi è ancora un dual write.
Come funziona:
flowchart LR
    cmd["Comando AnnullaOrdine"] --> agg["Aggregato Ordine"]
    store[("Event store ordine 42")] -- "replay eventi" --> agg
    agg -- "append OrdineAnnullato" --> store
    store --> snap[("Snapshot ogni 100 eventi")]
    snap -- "stato al v100" --> agg
store -- "stream eventi" --> proj["Proiezioni CQRS"]- Ogni cambiamento è un evento immutabile aggiunto in coda allo stream dell'aggregato:
OrdineCreato,ArticoloAggiunto,PagamentoEseguito,OrdineAnnullato. - Per gestire un comando, l'aggregato viene ricostruito facendo il replay di tutti i suoi eventi dall'inizio.
- Se gli eventi sono tanti, si salva uno snapshot periodico dello stato: il replay parte dallo snapshot e applica solo gli eventi successivi.
- L'event store è anche la fonte degli eventi per le proiezioni: non serve un outbox separato, perché lo stato è la lista degli eventi.
Quando usarlo: - Serve un audit completo e non contestabile (pagamenti, contabilità). - Vuoi poter rispondere a "com'era lo stato il 3 marzo" o ricostruire una proiezione da zero. - Il dominio ragiona naturalmente per eventi.
Quando NON usarlo / rischi: - Curva di apprendimento alta: cambia il modo di modellare, interrogare e testare. - Gli eventi vecchi restano per sempre: cambiare la forma di un evento richiede versioning e upcasting. - Le query sullo stato corrente richiedono quasi sempre CQRS: l'event store da solo serve male le liste. - Per un dominio semplice è un costo sproporzionato.
Esempio pratico: lo stream dell'ordine 42 contiene OrdineCreato, ArticoloAggiunto (scarpe x2), PagamentoEseguito (180.00), ScortaNonDisponibile, PagamentoRimborsato (180.00), OrdineAnnullato. Il supporto clienti vede l'intera storia. Il team finance ricostruisce il totale dei rimborsi di marzo facendo il replay degli eventi PagamentoRimborsato di tutti gli ordini, senza una tabella pensata in anticipo.
Pattern correlati: CQRS, Transactional Outbox, Saga Orchestrazione, Memento.
Transaction Log Tailing / CDC
In una frase: un connettore legge il log delle transazioni del database e trasforma ogni cambiamento in un messaggio sul broker.
Problema che risolve: il polling dell'outbox aggiunge latenza e carico. Il Change Data Capture (CDC) ottiene gli stessi cambiamenti dal log che il database scrive comunque, senza query ripetute e con latenza di millisecondi. Serve anche per replicare dati verso un altro sistema (cache, motore di ricerca, data warehouse) senza toccare il codice del servizio.
Come funziona:
flowchart LR
    ordini["📦 Ordini"] -->|"INSERT"| outbox[("📮 outbox")]
    subgraph pg["🐘 PostgreSQL"]
        outbox --> wal["📜 WAL"]
    end
    wal -->|"legge in streaming"| deb["🔌 Debezium"]
    deb --> kafka[["📨 Kafka"]]
    kafka --> pay["💳 Pagamenti"]
    kafka --> ricerca[("🔍 Indice ricerca")]
flowchart LR
svc["Servizio Ordini"] -- "INSERT outbox" --> db[("PostgreSQL")]
db -- "WAL" --> debezium["Debezium connector"]
debezium -- "topic ordini.eventi" --> kafka["Kafka"]
kafka --> pagamenti["Servizio Pagamenti"]
kafka --> search["Indice di ricerca Catalogo"]- Il database scrive ogni transazione nel suo log (WAL in PostgreSQL, binlog in MySQL) prima ancora di aggiornare le tabelle.
- Debezium si collega come se fosse una replica e legge il log in streaming.
- Per ogni riga inserita nella tabella
outboxproduce un messaggio Kafka, con la posizione nel log come offset: se riparte, riprende da dove era. - I consumatori leggono dal topic. Nessun polling, nessun codice di relay da scrivere.
Usato con la tabella outbox è la variante migliore del Transactional Outbox. Usato direttamente sulle tabelle di dominio espone lo schema interno del database agli altri servizi: evita, a meno che sia una replica tecnica (cache, ricerca).
Quando usarlo: - Hai già Kafka o un broker compatibile e puoi aggiungere Debezium. - Serve latenza bassa e volume alto di eventi. - Devi alimentare un indice di ricerca o una cache dal database senza modificare il servizio.
Quando NON usarlo / rischi:
- Componente infrastrutturale in più da configurare e monitorare (slot di replica, permessi, ritenzione del log).
- Il log espone la forma fisica delle righe: pubblica solo da una tabella outbox con payload già pensato come contratto.
- Database gestiti senza accesso al log (alcuni servizi cloud) non lo permettono.
Esempio pratico: Catalogo scrive i prodotti in PostgreSQL. Un connettore Debezium legge la tabella outbox e pubblica ProdottoAggiornato su Kafka. Un consumatore aggiorna l'indice Elasticsearch della ricerca. Il team Catalogo non ha scritto una riga di codice di pubblicazione.
Pattern correlati: Transactional Outbox, CQRS, Messaggistica asincrona.
Two-Phase Commit
In una frase: un coordinatore chiede a tutti i partecipanti di prepararsi, e solo se tutti dicono sì ordina il commit a tutti.
Problema che risolve: è la risposta classica al commit atomico su più database. Nei microservizi quasi non si usa, ma va conosciuto per capire perché le saghe esistono e per riconoscerlo nei sistemi legacy (XA, JTA, MSDTC).
Come funziona:
flowchart TD
coord["🧑⚖️ Coordinatore XA"]
dbO[("🗄️ DB Ordini")]
dbP[("🗄️ DB Pagamenti")]
lockO{{"🔒 Lock in attesa"}}
lockP{{"🔒 Lock in attesa"}}
http>"☁️ Pagamenti via HTTP"]
coord -->|"1. prepare, 2. commit"| dbO --> lockO
coord -->|"1. prepare, 2. commit"| dbP --> lockP
coord -.->|"🚫 non partecipa"| httpsequenceDiagram
participant C as Coordinatore
participant DBO as DB Ordini
participant DBP as DB Pagamenti
C->>DBO: PREPARE
C->>DBP: PREPARE
DBO-->>C: pronto (lock mantenuti)
DBP-->>C: pronto (lock mantenuti)
C->>DBO: COMMIT
C->>DBP: COMMIT
Note over C,DBP: se il coordinatore muore dopo PREPARE, i lock restano fino al suo ritorno- Fase 1, prepare: il coordinatore chiede a ogni database di eseguire la transazione fino al punto di commit, senza confermarla. Ogni partecipante risponde "pronto" e tiene i lock sulle righe.
- Fase 2, commit: se tutti hanno risposto "pronto", il coordinatore ordina il commit a tutti. Se anche uno ha detto no, ordina il rollback a tutti.
- Il protocollo è bloccante: fra le due fasi i partecipanti non possono liberare i lock. Se il coordinatore cade, restano bloccati finché non torna.
Perché non si usa nei microservizi:
- Tutti i partecipanti devono supportare il protocollo XA: molti database moderni, broker e API HTTP non lo fanno.
- I lock mantenuti fra le due fasi riducono il throughput e creano contese fra servizi.
- Il coordinatore è un punto singolo di fallimento e di accoppiamento fra tutti i servizi.
- Va contro il principio di Database per Service: il coordinatore deve conoscere i database di tutti.
Quando usarlo: - Dentro un monolite che tocca due database dello stesso team, con driver XA e volumi bassi. - Integrazione con sistemi legacy che lo richiedono.
Quando NON usarlo / rischi: - Fra microservizi: preferisci Saga Coreografia o Saga Orchestrazione, che accettano la coerenza eventuale in cambio di disponibilità. - Con servizi esposti via HTTP o con broker: non partecipano al protocollo. - Con traffico alto: i lock distribuiti sono un collo di bottiglia.
Esempio pratico: un vecchio sistema gestionale scrive l'ordine su Oracle e il movimento contabile su DB2 nella stessa transazione XA. Funziona finché i due database sono nello stesso datacenter e il volume è di poche centinaia di ordini all'ora. Quando Pagamenti diventa un servizio con API HTTP, il commit a due fasi non può più includerlo: l'ordine viene riscritto come saga.
Pattern correlati: Saga Coreografia, Saga Orchestrazione, Database per Service.
Come scegliere
flowchart TD
    q1{"I servizi condividono lo stesso database?"}
    q1 -- "sì" --> dbps["Database per Service"]
    q1 -- "no" --> q2{"Devi scrivere un dato e pubblicare un evento?"}
    q2 -- "sì" --> q3{"Hai Debezium o CDC disponibile?"}
    q3 -- "sì" --> cdc["Transactional Outbox con CDC"]
    q3 -- "no" --> poll["Transactional Outbox con polling"]
    cdc --> idem["Idempotent Consumer sempre"]
    poll --> idem
    q2 -- "no" --> q4{"Una operazione tocca più servizi?"}
    q4 -- "sì" --> q5{"Più di 4 passi, rami o timeout?"}
    q5 -- "sì" --> orch["Saga Orchestrazione"]
    q5 -- "no" --> chor["Saga Coreografia"]
    q4 -- "no" --> q6{"Letture complesse o su più servizi?"}
    q6 -- "sì" --> cqrs["CQRS"]
    q6 -- "no" --> q7{"Serve audit completo o replay dello stato?"}
    q7 -- "sì" --> es["Event Sourcing con CQRS"]
    q7 -- "no" --> fine["Transazione locale, nessun pattern"]
Regola pratica: parti da Database per Service, aggiungi Transactional Outbox e Idempotent Consumer appena un servizio pubblica eventi, introduci una Saga solo per le operazioni che toccano più servizi, e valuta CQRS ed Event Sourcing solo quando le letture o l'audit lo chiedono davvero. Two-Phase Commit resta un riferimento storico, non una opzione.