Pattern di comunicazione fra microservizi
I microservizi devono parlarsi per completare un lavoro. Il modo in cui lo fanno decide quanto il sistema è accoppiato, quanto è veloce e quanto è facile da capire quando qualcosa si rompe. Questa categoria raccoglie i pattern che regolano chi chiama chi, come e quando.
flowchart LR
    subgraph ingresso["🚪 Chi fa entrare i client"]
        gw["API Gateway"]
        bff["Backend for Frontend"]
    end
    subgraph trova["🔎 Come trovarsi"]
        sd["Service Discovery"]
    end
    subgraph messaggi["📨 Parlare tramite broker"]
        rr["Request-Reply asincrono"]
        ps["Publish/Subscribe"]
        mq["Competing Consumers"]
    end
    subgraph comporre["🧩 Dividere e ricomporre"]
        ff["Fan-out / Fan-in"]
        sg["Scatter-Gather"]
        agg["Aggregator"]
        pipe["Chain / Pipeline"]
    end
ingresso --> trova --> messaggi --> comporre| Pattern | Problema che risolve | Usalo quando |
|---|---|---|
| API Gateway | I client devono conoscere e chiamare troppi servizi | Hai molti servizi esposti e vuoi un solo ingresso |
| Backend for Frontend | Client diversi vogliono dati diversi dalla stessa API | Web, mobile e partner hanno esigenze molto diverse |
| Service Discovery | Gli indirizzi dei servizi cambiano di continuo | Le istanze nascono e muoiono dinamicamente |
| Request-Reply asincrono | Serve una risposta ma senza bloccare il chiamante | Operazioni lente che devono comunque restituire un esito |
| Publish/Subscribe | Un evento interessa a molti servizi che non conosci | Vuoi aggiungere consumer senza toccare il produttore |
| Message Queue / Competing Consumers | Troppi lavori per un solo consumer | Devi scalare l'elaborazione aggiungendo istanze |
| Fan-out / Fan-in | Un lavoro grande va spezzato e poi ricomposto | Elaborazioni parallele con risultato unico finale |
| Scatter-Gather | Servono risposte da più fonti entro un tempo limite | Confronti o ricerche su più servizi con timeout |
| Aggregator / API Composition | Una pagina ha bisogno di dati da più servizi | Letture che uniscono più domini in una risposta |
| Chain / Pipeline | Un'elaborazione ha più stadi in sequenza | Ogni stadio è indipendente e trasforma l'input |
Sincrono vs asincrono
Nella comunicazione sincrona il chiamante manda una richiesta e aspetta la risposta (HTTP, gRPC). Nella comunicazione asincrona il chiamante mette un messaggio su un broker e continua il suo lavoro; chi è interessato lo leggerà quando può.
flowchart LR
    subgraph sync["Sincrono: request e response"]
        ordiniS["Ordini"] -- "POST /pagamenti" --> pagamentiS["Pagamenti"]
        pagamentiS -- "200 OK" --> ordiniS
    end
    subgraph async["Asincrono: messaggio su broker"]
        ordiniA["Ordini"] -- "OrdineCreato" --> broker["Broker"]
        broker --> pagamentiA["Pagamenti"]
        broker --> notificheA["Notifiche"]
end| Aspetto | Sincrono | Asincrono |
|---|---|---|
| Latenza | Bassa per il singolo scambio, ma somma le attese lungo la catena | Più alta per il singolo messaggio, ma il chiamante non aspetta |
| Accoppiamento | Forte: il chiamante conosce il servizio e deve trovarlo attivo | Debole: produttore e consumer conoscono solo il broker |
| Consistenza | Immediata: la risposta dice subito se è andata bene | Eventuale: il dato diventa coerente dopo un po' |
| Debug | Semplice: lo stack trace segue la chiamata | Difficile: serve tracciare i messaggi con un id condiviso |
| Guasti | Se il destinatario è giù, il chiamante fallisce | Il broker trattiene il messaggio finché il consumer torna |
| Preferiscilo quando | L'utente aspetta una risposta ora (login, controllo prezzo) | Il lavoro può aspettare o interessa a più servizi (email, report, indicizzazione) |
Regola pratica: sincrono per le letture che l'utente guarda in tempo reale, asincrono per tutto ciò che è un effetto collaterale di un'azione.
API Gateway
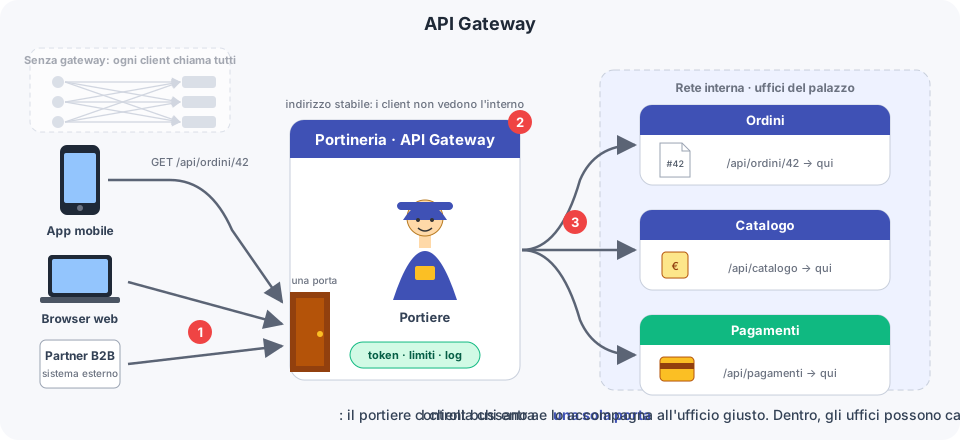
In una frase: Un unico punto di ingresso che riceve tutte le chiamate dei client e le inoltra ai servizi giusti.
Problema che risolve: Senza gateway l'app mobile deve conoscere l'indirizzo di Ordini, Catalogo, Pagamenti e ognuno di questi deve gestire da solo autenticazione, limiti di traffico e log. Ogni volta che un servizio cambia indirizzo o si divide in due, devi aggiornare tutti i client.
Come funziona:
flowchart LR
    web["Client web"] --> gw["API Gateway"]
    mobile["Client mobile"] --> gw
    gw -- "/ordini" --> ordini["Ordini"]
    gw -- "/catalogo" --> catalogo["Catalogo"]
    gw -- "/pagamenti" --> pagamenti["Pagamenti"]
gw -. "verifica token, rate limit, log" .-> gw- Il client chiama sempre e solo il gateway, con un indirizzo stabile.
- Il gateway verifica il token, applica i limiti di traffico e registra la chiamata.
- In base al percorso (
/ordini,/catalogo) inoltra la richiesta al servizio interno. - La risposta torna al client attraverso il gateway, che può tradurre formati o nascondere dettagli interni.
Quando usarlo: - Hai più di due o tre servizi esposti all'esterno. - Vuoi centralizzare autenticazione, rate limiting, TLS e log di accesso. - I servizi interni cambiano spesso indirizzo o struttura.
Quando NON usarlo / rischi: - Con un solo servizio è un livello in più senza vantaggi. - Il gateway è un punto unico di guasto: deve essere ridondato. - Se ci metti logica di dominio diventa un "monolite distribuito" da cui tutti dipendono.
Esempio pratico: L'app mobile chiama GET /api/ordini/42. Il gateway controlla il JWT, verifica che l'utente non abbia superato 100 richieste al minuto e inoltra a Ordini su http://ordini.interno:8080/ordini/42. Se domani Ordini si divide in Ordini e Spedizioni, aggiorni solo la regola di routing nel gateway.
Pattern correlati: Backend for Frontend, Aggregator / API Composition, Circuit Breaker, Rate Limiting, Facade.
Backend for Frontend (BFF)
In una frase: Un gateway dedicato a ogni tipo di client, che restituisce esattamente i dati di cui quel client ha bisogno.
Problema che risolve: La pagina prodotto sul web mostra 30 campi e le recensioni; l'app mobile ne mostra 5 e vuole immagini piccole. Con un'unica API generica il mobile scarica dati inutili e il web fa tre chiamate dove ne basterebbe una. Ogni team client chiede modifiche all'API e i cambi si bloccano a vicenda.
Come funziona:
flowchart LR
web(["🧑💻 Utente web"]) -->|"30 campi, immagini 800px"| bffWeb{{"🖥️ BFF Web"}}
mobile(["📱 Utente mobile"]) -->|"5 campi, miniature 100px"| bffMobile{{"📱 BFF Mobile"}}
bffWeb --> catalogo["🏷️ Catalogo"]
bffWeb --> ordini["📦 Ordini"]
bffMobile --> catalogo
bffMobile --> ordiniflowchart LR
web["Client web"] --> bffWeb["BFF Web"]
mobile["Client mobile"] --> bffMobile["BFF Mobile"]
bffWeb --> catalogo["Catalogo"]
bffWeb --> ordini["Ordini"]
bffMobile --> catalogo
bffMobile --> ordini
bffMobile --> notifiche["Notifiche"]- Ogni tipo di client ha il suo BFF, di solito gestito dal team di quel client.
- Il BFF chiama i servizi interni e compone una risposta su misura: campi, formati, dimensioni delle immagini.
- I servizi interni restano generici e non sanno nulla dei client.
- Un cambio nella schermata mobile tocca solo il BFF mobile.
Quando usarlo: - Hai client con esigenze molto diverse (web, mobile, smart TV, partner). - I team client vogliono autonomia sul contratto delle API. - Vuoi ridurre il numero di chiamate che un client fa per una singola schermata.
Quando NON usarlo / rischi: - Con un solo client è duplicazione inutile: basta un API Gateway. - La logica tende a duplicarsi fra BFF: tienila nei servizi di dominio. - Più BFF significano più cose da rilasciare e monitorare.
Esempio pratico: La schermata "I miei ordini" nell'app mobile chiama GET /bff-mobile/ordini. Il BFF mobile chiama Ordini per la lista, Catalogo per le miniature a 100 px e restituisce un JSON con 4 campi per ordine. Il BFF web, per la stessa pagina, aggiunge lo storico pagamenti e le immagini a 800 px.
Pattern correlati: API Gateway, Aggregator / API Composition, Adapter.
Service Discovery
In una frase: Un registro che sa dove sono le istanze attive di ogni servizio, così nessuno deve avere indirizzi scritti nel codice.
Problema che risolve: In un cluster le istanze di Pagamenti nascono, muoiono e cambiano IP ogni giorno. Se Ordini ha l'indirizzo scritto in configurazione, ogni cambio richiede un rilascio e nel frattempo le chiamate falliscono.
Come funziona:
flowchart LR
    ordini["📦 Ordini"] -->|"1. dove sta Pagamenti?"| registro[("📒 Registro servizi")]
    registro -->|"2. 10.0.0.5, 10.0.0.9"| ordini
    subgraph istanze["💳 Istanze Pagamenti"]
        p1["Pagamenti 1 - 10.0.0.5"]
        p2["Pagamenti 2 - 10.0.0.9"]
        p3["Pagamenti 3 - nuova"]
    end
    ordini -->|"3. chiama"| p1
    p3 -.->|"👋 mi registro"| registro
Esistono due varianti. Nella client-side discovery il chiamante interroga il registro e sceglie da solo l'istanza. Nella server-side discovery il chiamante parla con un bilanciatore, che interroga il registro al posto suo.
flowchart LR
    subgraph client["Client-side discovery"]
        ordiniC["Ordini"] -- "1. dove sta Pagamenti?" --> registroC["Registro"]
        registroC -- "2. lista istanze" --> ordiniC
        ordiniC -- "3. chiama istanza scelta" --> pagC1["Pagamenti 1"]
        ordiniC -.-> pagC2["Pagamenti 2"]
    end
flowchart LR
subgraph server["Server-side discovery"]
ordiniS["Ordini"] -- "1. chiama pagamenti" --> lb["Bilanciatore"]
lb -- "2. dove sta Pagamenti?" --> registroS["Registro"]
lb -- "3. inoltra" --> pagS1["Pagamenti 1"]
lb -.-> pagS2["Pagamenti 2"]
end- Ogni istanza di
Pagamenti, all'avvio, si registra nel registro (Consul, Eureka, il DNS di Kubernetes) e manda un segnale periodico di vita. - Client-side:
Ordinichiede al registro la lista delle istanze e ne sceglie una con una logica di bilanciamento propria. - Server-side:
Ordinichiama un nome stabile (pagamenti) e il bilanciatore o la piattaforma risolve l'istanza. - Quando un'istanza smette di mandare il segnale di vita, il registro la toglie dalla lista.
Quando usarlo: - Le istanze cambiano indirizzo in modo dinamico (container, autoscaling). - Vuoi aggiungere o togliere istanze senza riconfigurare i chiamanti. - Server-side è la scelta di default su Kubernetes: lo fa la piattaforma.
Quando NON usarlo / rischi: - Con pochi servizi su indirizzi fissi basta un DNS statico. - Client-side mette logica di rete in ogni servizio e lega il codice alla libreria del registro. - Il registro è un componente critico: se è giù nessuno trova nessuno.
Esempio pratico: Su Kubernetes Ordini chiama http://pagamenti:8080/paga. Il DNS del cluster risolve pagamenti nel Service, che bilancia fra i pod attivi. Quando l'autoscaler aggiunge un terzo pod di Pagamenti, inizia a ricevere traffico senza che Ordini cambi nulla.
Pattern correlati: API Gateway, Health Check, Sidecar.
Request-Reply asincrono
In una frase: Il chiamante manda una richiesta su una coda e riceve la risposta su un'altra coda, abbinata tramite un correlation id.
Problema che risolve: Ordini ha bisogno dell'esito del pagamento, ma il pagamento può richiedere 30 secondi per i controlli antifrode. Una chiamata HTTP bloccata per 30 secondi occupa connessioni, va in timeout e, se Pagamenti è momentaneamente giù, si perde.
Come funziona:
flowchart LR
    ordini["📦 Ordini"] -->|"✉️ PagaOrdine, id abc, replyTo risposte"| richieste[["📨 Coda richieste"]]
    richieste --> pagamenti["💳 Pagamenti"]
    pagamenti -->|"✉️ Esito, id abc"| risposte[["📬 Coda risposte"]]
    risposte -->|"abbina abc"| ordini
    ordini -.->|"intanto serve altri clienti"| cliente(["🧑 Cliente"])
sequenceDiagram
participant O as Ordini
participant RQ as Coda richieste
participant P as Pagamenti
participant RP as Coda risposte
O->>RQ: PagaOrdine {correlationId=abc, replyTo=risposte}
O->>O: continua altro lavoro
RQ->>P: consuma PagaOrdine
P->>P: elabora pagamento
P->>RP: PagamentoEsito {correlationId=abc}
RP->>O: consuma esito
O->>O: abbina abc alla richiesta originaleOrdinipubblica la richiesta con due intestazioni:correlationIdunivoco ereplyTo, il nome della coda su cui vuole la risposta.Ordininon aspetta: salva lo stato "in attesa di pagamento" e serve altre richieste.Pagamenticonsuma, elabora e pubblica l'esito sulla coda indicata inreplyTo, copiando lo stessocorrelationId.Ordinilegge la coda delle risposte e usa ilcorrelationIdper capire a quale ordine si riferisce l'esito.
Quando usarlo: - Serve una risposta, ma l'elaborazione è lenta o può fallire temporaneamente. - Vuoi che il chiamante sopravviva a un riavvio del servizio che risponde. - Vuoi disaccoppiare il ritmo del chiamante da quello di chi risponde.
Quando NON usarlo / rischi: - Se l'utente aspetta la risposta sullo schermo entro pochi millisecondi: usa una chiamata sincrona. - Devi gestire le risposte che non arrivano mai: serve un timeout e uno stato "scaduto". - Il codice è più complesso: lo stato della richiesta deve sopravvivere fra invio e risposta.
Esempio pratico: Ordini pubblica PagaOrdine con correlationId=ord-42. Risponde subito al cliente "ordine ricevuto, pagamento in corso". Dopo 20 secondi arriva PagamentoEsito con ord-42 e stato=approvato: Ordini aggiorna l'ordine e pubblica OrdineConfermato. Se dopo 5 minuti non arriva nulla, l'ordine passa a "da verificare".
Pattern correlati: Message Queue / Competing Consumers, Scatter-Gather, Saga, Timeout.
Publish/Subscribe
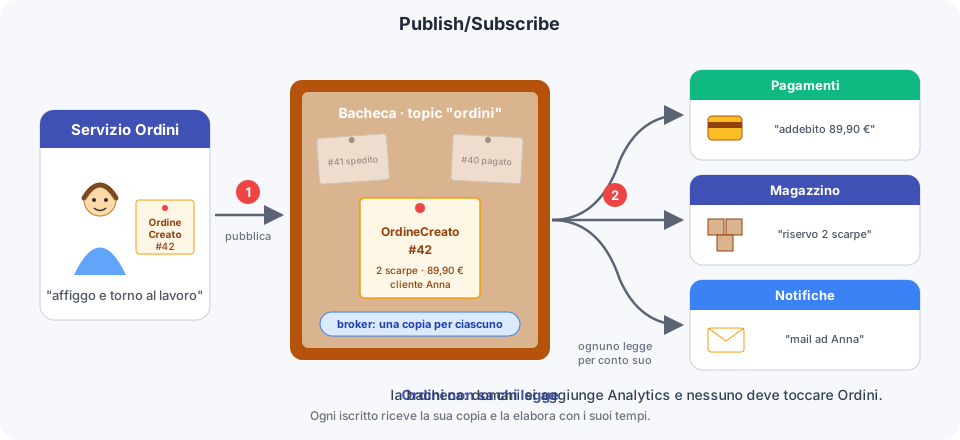
In una frase: Un servizio pubblica un evento su un topic e tutti i servizi iscritti lo ricevono, senza che il produttore sappia chi sono.
Problema che risolve: Quando un ordine viene creato, Pagamenti deve incassare, Magazzino deve riservare la merce, Notifiche deve mandare l'email. Se Ordini chiama tutti e tre, ogni nuovo interessato richiede una modifica a Ordini e un guasto in uno blocca gli altri.
Come funziona:
flowchart LR
    ordini["Ordini"] -- "pubblica OrdineCreato" --> topic["Topic ordini"]
    topic --> pagamenti["Pagamenti"]
    topic --> magazzino["Magazzino"]
topic --> notifiche["Notifiche"]Ordinipubblica l'eventoOrdineCreatosul topicordinie ha finito: non sa chi lo leggerà.- Il broker consegna una copia dell'evento a ogni sottoscrizione attiva.
- Ogni consumer elabora l'evento con i suoi tempi e, se cade, riprende dal punto in cui era rimasto.
- Per aggiungere un nuovo interessato (per esempio
Analytics) basta una nuova sottoscrizione.
Quando usarlo: - Un fatto di dominio interessa a più servizi. - Vuoi aggiungere consumer senza modificare il produttore. - Accetti la consistenza eventuale.
Quando NON usarlo / rischi: - Se il produttore ha bisogno di una risposta: pub/sub è "fire and forget". - È difficile vedere "chi dipende da cosa": documenta i topic e gli eventi. - I consumer devono essere idempotenti: lo stesso evento può arrivare due volte. - L'ordine degli eventi non è garantito fra partizioni diverse.
Esempio pratico: Ordini pubblica OrdineCreato {ordineId: 42, righe: [...]}. Magazzino riserva le quantità, Pagamenti avvia l'incasso, Notifiche manda l'email "abbiamo ricevuto il tuo ordine". Tre mesi dopo il team marketing aggiunge Raccomandazioni, che legge lo stesso topic: Ordini non viene toccato.
Pattern correlati: Message Queue / Competing Consumers, Event Sourcing, Transactional Outbox, Observer.
Message Queue / Competing Consumers
In una frase: Una coda punto-punto in cui più istanze dello stesso consumer si contendono i messaggi, e ogni messaggio viene elaborato da una sola istanza.
Problema che risolve: Notifiche deve generare 50.000 email dopo una promozione. Una sola istanza impiega ore. Se lanci più istanze che leggono dalla stessa fonte, rischi di mandare la stessa email tre volte.
Come funziona:
flowchart LR
    promo(["🛍️ Black Friday"]) -->|"50.000 InviaEmail"| coda[["📨 Coda notifiche"]]
    coda -->|"msg 1"| n1["✉️ Notifiche 1"]
    coda -->|"msg 2"| n2["✉️ Notifiche 2"]
    coda -->|"msg 3"| n3["✉️ Notifiche 3"]
    n2 -.->|"indirizzo malformato"| dlq[["☠️ Dead letter queue"]]
flowchart LR
ordini["Ordini"] -- "InviaEmail" --> coda["Coda notifiche"]
coda --> n1["Notifiche 1"]
coda --> n2["Notifiche 2"]
coda --> n3["Notifiche 3"]- Il produttore mette i messaggi in coda; il broker li conserva finché qualcuno li prende.
- Più istanze di
Notificheleggono dalla stessa coda: il broker consegna ogni messaggio a una sola istanza. - L'istanza conferma (
ack) il messaggio solo dopo averlo elaborato; se cade prima, il broker lo riconsegna a un'altra. - Per aumentare la velocità aggiungi istanze; per ridurre i costi le togli.
La differenza con Publish/Subscribe: lì ogni consumer riceve una copia di ogni messaggio; qui i consumer si dividono i messaggi.
Quando usarlo: - Hai un carico di lavoro che vuoi distribuire su più lavoratori identici. - Il lavoro può essere fatto in modo asincrono e in qualsiasi ordine. - Vuoi assorbire picchi: la coda cresce, i consumer smaltiscono con calma.
Quando NON usarlo / rischi: - Se l'ordine dei messaggi è importante: due istanze elaborano in parallelo e l'ordine si perde. - Un messaggio che fa sempre fallire il consumer blocca la coda: serve una dead letter queue. - I consumer devono essere idempotenti per gestire le riconsegne.
Esempio pratico: La promozione del Black Friday mette 50.000 messaggi InviaEmail nella coda. L'autoscaler vede la coda crescere e porta Notifiche da 2 a 10 istanze. Ogni istanza prende un messaggio, manda l'email e conferma. Un messaggio con un indirizzo malformato fallisce tre volte e finisce nella dead letter queue per essere controllato a mano.
Pattern correlati: Publish/Subscribe, Fan-out / Fan-in, Dead Letter Queue, Idempotent Consumer.
Fan-out / Fan-in
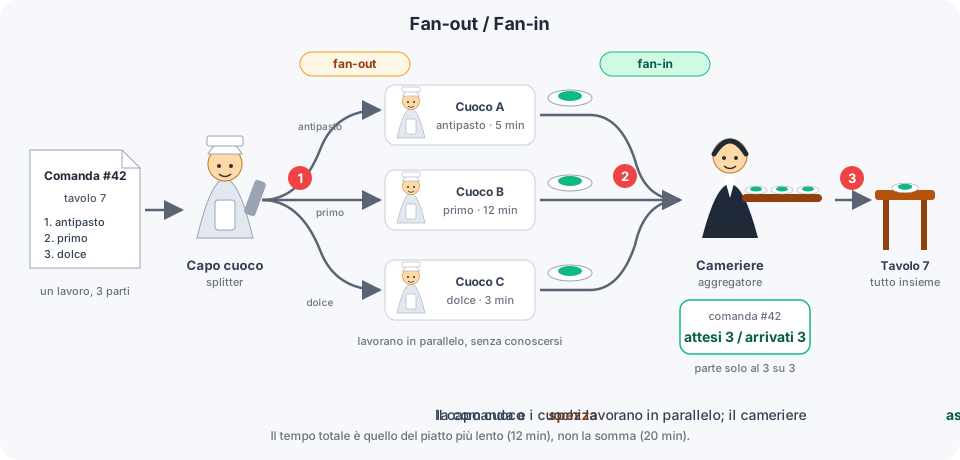
In una frase: Un lavoro viene spezzato e distribuito a N lavoratori (fan-out), e un aggregatore ricompone i risultati parziali in uno solo (fan-in).
Problema che risolve: Un ordine con 200 righe deve essere verificato contro il magazzino di 5 depositi diversi. Farlo in sequenza richiede minuti. Vuoi verificare i depositi in parallelo, ma alla fine ti serve una sola risposta: "l'ordine è evadibile o no".
Come funziona:
flowchart LR
    ordini["Ordini"] -- "VerificaOrdine" --> splitter["Splitter"]
    splitter -- "parte 1" --> w1["Magazzino Nord"]
    splitter -- "parte 2" --> w2["Magazzino Centro"]
    splitter -- "parte 3" --> w3["Magazzino Sud"]
    w1 -- "esito 1" --> agg["Aggregatore"]
    w2 -- "esito 2" --> agg
    w3 -- "esito 3" --> agg
agg -- "OrdineVerificato" --> ordini- Fan-out: lo splitter riceve il lavoro, lo divide in parti e manda ogni parte a un lavoratore. Le parti viaggiano in parallelo.
- Ogni lavoratore elabora la sua parte senza sapere delle altre e pubblica un risultato parziale, marcato con l'id del lavoro originale e il numero di parti attese.
- Fan-in: l'aggregatore raccoglie i risultati parziali con lo stesso id. Deve ricordare quanti ne aspetta e quanti ne ha ricevuti.
- Quando ha tutte le parti (o scade un tempo massimo) l'aggregatore calcola il risultato finale e lo pubblica.
Fan-out e fan-in sono due metà distinte. Il fan-out è facile: è solo mandare N messaggi. Il fan-in è la parte delicata: l'aggregatore ha uno stato (quante parti mancano), deve sopravvivere ai riavvii, deve decidere cosa fare se una parte non arriva mai e deve gestire i duplicati.
Quando usarlo: - Un lavoro grande si divide in parti indipendenti e vuoi ridurre il tempo totale. - Il risultato finale ha senso solo quando tutte le parti sono pronte. - Lavori batch: report, verifiche su molti depositi, elaborazione di immagini.
Quando NON usarlo / rischi: - Se le parti dipendono l'una dall'altra: usa una Pipeline. - L'aggregatore è complesso: stato persistente, timeout, gestione parti mancanti e duplicate. - Con poche parti piccole il costo di coordinamento supera il guadagno.
Esempio pratico: Ordini chiede la verifica dell'ordine 42. Lo splitter raggruppa le 200 righe per deposito e manda 3 messaggi. Ogni Magazzino risponde con le righe disponibili. L'aggregatore, che ha salvato "ordine 42: attese 3 parti", riceve le tre risposte, calcola che 2 righe non sono disponibili in nessun deposito e pubblica OrdineVerificato {evadibile: false, mancanti: [..]}.
Pattern correlati: Scatter-Gather, Message Queue / Competing Consumers, Aggregator / API Composition, Saga.
Scatter-Gather
In una frase: Mandi la stessa richiesta a più servizi in parallelo, aspetti le risposte entro un timeout e usi quelle che sono arrivate.
Problema che risolve: Per mostrare il prezzo migliore di un prodotto devi interrogare tre fornitori di spedizione. Chiamarli uno dopo l'altro è lento, e se uno di loro è lento o giù la pagina non deve restare bloccata per sempre.
Come funziona:
flowchart LR
    checkout{{"🛒 Checkout - timeout 500 ms"}}
    checkout <-->|"5,50 in 300 ms"| a>"🚚 Corriere A"]
    checkout <-->|"4,90 in 120 ms"| b>"🚚 Corriere B"]
    checkout -.->|"❌ nessuna risposta, scartato"| c>"🚚 Corriere C"]
    checkout -->|"il migliore"| scelta[/"📄 Spedizione a 4,90 euro"/]
sequenceDiagram
participant C as Checkout
participant S1 as Corriere A
participant S2 as Corriere B
participant S3 as Corriere C
C->>S1: preventivo spedizione
C->>S2: preventivo spedizione
C->>S3: preventivo spedizione
S2-->>C: 4,90 euro
S1-->>C: 5,50 euro
Note over C: timeout 500 ms scaduto
C->>C: scarta S3, sceglie il migliore
Note over C: risposta al cliente con 4,90 euroCheckoutmanda la stessa richiesta a tutti i destinatari in parallelo (scatter).- Avvia un timer: le risposte che arrivano entro il tempo limite vengono raccolte (gather).
- Allo scadere del timer, elabora quelle che ha: le confronta, le somma o sceglie la migliore.
- Le risposte in ritardo vengono ignorate: il chiamante risponde con quello che ha.
Differenza con Fan-out / Fan-in: lì ogni lavoratore riceve una parte diversa del lavoro e servono tutte le parti; qui ogni destinatario riceve la stessa domanda e si può rispondere anche con risultati parziali.
Quando usarlo: - Devi confrontare offerte, prezzi o disponibilità da più fonti equivalenti. - Una risposta parziale è meglio di nessuna risposta. - Vuoi un tempo di risposta prevedibile anche se una fonte è lenta.
Quando NON usarlo / rischi: - Se tutte le risposte sono obbligatorie: usa Fan-out / Fan-in. - Il timeout è una scelta delicata: troppo corto scarta fonti buone, troppo lungo rallenta tutto. - Moltiplica il traffico: N richieste per ogni richiesta dell'utente.
Esempio pratico: Al checkout l'utente inserisce il CAP. Checkout chiede in parallelo un preventivo a tre corrieri con timeout di 500 ms. Rispondono due. La pagina mostra la spedizione a 4,90 euro. Il terzo corriere risponde dopo 2 secondi e la risposta viene scartata.
Pattern correlati: Fan-out / Fan-in, Request-Reply asincrono, Timeout, Fallback.
Aggregator / API Composition
In una frase: Un servizio che riceve una richiesta, chiama più servizi di dominio e restituisce una risposta unica già composta.
Problema che risolve: La pagina "dettaglio ordine" ha bisogno dell'ordine (Ordini), del nome e delle immagini dei prodotti (Catalogo), dello stato del pagamento (Pagamenti) e della spedizione (Magazzino). Se il client fa quattro chiamate, la pagina è lenta e la logica di composizione finisce nel frontend.
Come funziona:
flowchart LR
    cliente(["🧑 Cliente"]) -->|"GET dettaglio ordine 42"| agg{{"🧩 Aggregatore"}}
    agg -->|"1."| ordini["📦 Ordini"]
    agg -->|"2. in parallelo"| catalogo["🏷️ Catalogo"]
    agg -->|"2. in parallelo"| pagamenti["💳 Pagamenti"]
    agg -->|"compone"| pagina[/"📄 Pagina - ordine, prodotti, pagamento"/]
    pagina --> cliente
sequenceDiagram
participant C as Client
participant A as Aggregatore
participant O as Ordini
participant K as Catalogo
participant P as Pagamenti
C->>A: GET dettaglio ordine 42
A->>O: GET ordine 42
O-->>A: ordine con righe
par in parallelo
A->>K: GET prodotti [p1, p2]
K-->>A: nomi e immagini
and
A->>P: GET pagamento ordine 42
P-->>A: stato approvato
end
A-->>C: risposta composta- Il client fa una sola chiamata all'aggregatore.
- L'aggregatore chiama prima
Ordiniperché gli servono gli id dei prodotti. - Con quegli id chiama
CatalogoePagamentiin parallelo, per non sommare le latenze. - Unisce le risposte in un unico JSON e lo restituisce. Se una fonte secondaria fallisce, può rispondere comunque con un campo vuoto.
Quando usarlo: - Una vista ha bisogno di dati che vivono in più servizi. - Vuoi tenere i client semplici e la composizione lato server. - Le letture sono frequenti e vuoi ottimizzarle con chiamate parallele e cache.
Quando NON usarlo / rischi: - Join su grandi quantità di dati in memoria: considera CQRS con una vista materializzata. - L'aggregatore dipende da tutti i servizi che chiama: la sua disponibilità è il prodotto delle loro. - Rischio di mettere logica di dominio nell'aggregatore: deve solo comporre, non decidere.
Esempio pratico: GET /ordini/42/dettaglio arriva all'aggregatore. Chiama Ordini, poi in parallelo Catalogo per i 3 prodotti e Pagamenti per lo stato. Risponde in 80 ms con un JSON unico. Se Pagamenti non risponde entro 200 ms, il campo pagamento vale null e la pagina mostra "stato non disponibile".
Pattern correlati: API Gateway, Backend for Frontend, CQRS, Circuit Breaker, Facade.
Chain / Pipeline
In una frase: Un messaggio attraversa una sequenza di stadi, e ogni stadio trasforma l'input e lo passa al successivo.
Problema che risolve: Un ordine in arrivo deve essere validato, arricchito con i prezzi, controllato per frode e poi salvato. Se un solo servizio fa tutto, diventa grande e difficile da cambiare; se ogni passo chiama il successivo in modo sincrono, un rallentamento in fondo blocca tutto.
Come funziona:
flowchart LR
    grezzo[/"📄 Ordine grezzo"/] --> valida["✅ Validazione"]
    valida --> q1[["📨 coda 1"]] --> arricchisci["🏷️ Arricchimento prezzi"]
    arricchisci --> q2[["📨 coda 2"]] --> frode{{"🕵️ Controllo frode"}}
    frode --> q3[["📨 coda 3"]] --> salva["💾 Salvataggio"]
    frode -.->|"punteggio alto"| revisione[["🙋 Revisione manuale"]]
flowchart LR
in["Ordine grezzo"] --> valida["Validazione"]
valida -- "coda 1" --> arricchisci["Arricchimento prezzi"]
arricchisci -- "coda 2" --> frode["Controllo frode"]
frode -- "coda 3" --> salva["Salvataggio"]
salva --> out["OrdineCreato"]- Ogni stadio legge da una coda di ingresso, fa un solo lavoro e scrive su una coda di uscita.
- Gli stadi non si conoscono:
Validazionesa solo che scrive sucoda 1, non chi la legge. - Ogni stadio si scala in modo indipendente: se il controllo frode è lento, aumenti solo le sue istanze.
- Per aggiungere un passo (per esempio "calcolo sconti") inserisci un nuovo stadio fra due code, senza toccare gli altri.
Quando usarlo: - L'elaborazione ha stadi chiari, in sequenza, ciascuno con una responsabilità. - Gli stadi hanno carichi diversi e vuoi scalarli separatamente. - Vuoi poter aggiungere, togliere o riordinare stadi con poco impatto.
Quando NON usarlo / rischi: - Se gli stadi sono due e semplici: una funzione che chiama l'altra basta. - Ogni coda aggiunge latenza: una pipeline di 8 stadi non è adatta a risposte in tempo reale. - Tracciare un messaggio lungo la catena richiede un correlation id e tracing distribuito. - Se uno stadio deve tornare indietro (compensare), serve una Saga, non una pipeline.
Esempio pratico: Un ordine entra come JSON grezzo. Validazione controlla i campi obbligatori e lo passa avanti. Arricchimento chiede i prezzi a Catalogo e aggiunge i totali. Controllo frode calcola un punteggio e, se è alto, devia l'ordine su una coda di revisione manuale. Salvataggio scrive l'ordine e pubblica OrdineCreato. Il correlation id ord-42 segue il messaggio in tutti gli stadi.
Pattern correlati: Message Queue / Competing Consumers, Fan-out / Fan-in, Saga, Distributed Tracing, Chain of Responsibility.
Come scegliere
flowchart TD
    q1{"I client esterni chiamano molti servizi?"}
    q1 -- "sì" --> q2{"Client con esigenze molto diverse?"}
    q2 -- "sì" --> bff["Backend for Frontend"]
    q2 -- "no" --> gw["API Gateway"]
    q1 -- "no" --> q3{"Le istanze cambiano indirizzo?"}
    q3 -- "sì" --> sd["Service Discovery"]
    q3 -- "no" --> q4{"Serve una risposta subito?"}
    q4 -- "sì" --> q5{"Dati da più servizi?"}
    q5 -- "sì" --> q6{"Stessa domanda a fonti equivalenti con timeout?"}
    q6 -- "sì" --> sg["Scatter-Gather"]
    q6 -- "no" --> agg["Aggregator / API Composition"]
    q5 -- "no" --> sync["Chiamata sincrona diretta"]
    q4 -- "no" --> q7{"Serve comunque un esito?"}
    q7 -- "sì" --> rr["Request-Reply asincrono"]
    q7 -- "no" --> q8{"Più servizi interessati allo stesso evento?"}
    q8 -- "sì" --> ps["Publish/Subscribe"]
    q8 -- "no" --> q9{"Il lavoro va diviso in parti e ricomposto?"}
    q9 -- "sì" --> ff["Fan-out / Fan-in"]
    q9 -- "no" --> q10{"Elaborazione a stadi in sequenza?"}
    q10 -- "sì" --> pipe["Chain / Pipeline"]
    q10 -- "no" --> mq["Message Queue / Competing Consumers"]