Pattern di resilienza
In un sistema a microservizi il fallimento non è un'eccezione: è la norma. La rete perde pacchetti, un servizio risponde lento, un database si satura. I pattern di resilienza servono a contenere questi guasti, in modo che un problema locale non diventi un blackout globale.
flowchart LR
    subgraph uscita["📤 Proteggere chi chiama"]
        timeout["⏱️ Timeout"]
        retry["🔁 Retry con backoff"]
        breaker["🔌 Circuit Breaker"]
        bulkhead["🚢 Bulkhead"]
        fallback["🛟 Fallback"]
    end
    subgraph ingresso["📥 Proteggere chi riceve"]
        rate["🎟️ Rate Limiting"]
        shed["🚪 Load Shedding"]
    end
    subgraph infra["🩺 Infrastruttura e code"]
        health["🩺 Health Check"]
        dlq["📮 Dead Letter Queue"]
end| Pattern | Problema che risolve | Usalo quando |
|---|---|---|
| Timeout | Una chiamata lenta blocca il chiamante per sempre | Ogni chiamata di rete, senza eccezioni |
| Retry con backoff esponenziale e jitter | Errori transitori fanno fallire operazioni che riproverebbero bene | Errori temporanei su operazioni idempotenti |
| Circuit Breaker | Si continua a chiamare un servizio già morto | Dipendenze che possono restare giù per minuti |
| Bulkhead | Una dipendenza lenta consuma tutte le risorse condivise | Più dipendenze con criticità diversa nello stesso processo |
| Rate Limiting / Throttling | Troppe richieste travolgono un servizio | Proteggere API pubbliche o risorse con capacità fissa |
| Fallback / Graceful Degradation | Una dipendenza giù rende inutile l'intera pagina | Esiste una risposta "meno buona ma accettabile" |
| Dead Letter Queue | Un messaggio malformato blocca la coda per tutti | Elaborazione asincrona tramite code o topic |
| Health Check | L'orchestratore manda traffico a istanze rotte | Sempre, in ambienti con Kubernetes o load balancer |
| Load Shedding / Backpressure | Sotto picco il servizio rallenta per tutti invece di servire alcuni | Picchi di traffico oltre la capacità del servizio |
Perché serve
Un servizio lento è più pericoloso di un servizio morto. Se Pagamenti muore, Ordini riceve subito un errore e lo gestisce. Se Pagamenti risponde in 30 secondi, ogni richiesta di Ordini resta appesa per 30 secondi e occupa un thread. In pochi secondi i thread di Ordini finiscono. A quel punto anche Carrello, che chiama Ordini, resta appeso. Questo è il fallimento a cascata.
flowchart LR
    utente["Utenti"] --> carrello["Carrello"]
    carrello -->|"attende"| ordini["Ordini - pool thread pieno"]
    ordini -->|"attende 30s"| pagamenti["Pagamenti - lento"]
    ordini -.->|"non serve più"| magazzino["Magazzino - sano"]
    carrello -.->|"non serve più"| catalogo["Catalogo - sano"]
Il guasto parte da Pagamenti, ma a cadere sono Ordini e Carrello, che smettono di servire anche le chiamate verso Magazzino e Catalogo, che stanno benissimo. I pattern di questo file rompono la catena in punti diversi: il Timeout libera i thread, il Circuit Breaker smette di chiamare chi è rotto, il Bulkhead evita che un pool pieno blocchi gli altri.
Timeout
In una frase: ogni chiamata verso l'esterno ha un tempo massimo di attesa, superato il quale fallisce.
Problema che risolve: senza timeout, una chiamata a un servizio lento o irraggiungibile resta appesa per sempre. Il thread del chiamante resta occupato, le connessioni non vengono liberate, e in breve il chiamante smette di rispondere anche a chi non c'entra nulla.
Come funziona:
flowchart LR
    cliente(["🧑 Cliente al checkout"]) -->|"1. paga ora"| ordini["📦 Ordini"]
    ordini -->|"2. addebita"| pay["💳 Pagamenti lento"]
    ordini -->|"3. parte il timer"| timer{{"⏱️ 2 secondi"}}
    timer -->|"4. scaduto, libera il thread"| ordini
    ordini -->|"5. pagamento in sospeso"| cliente
sequenceDiagram
participant O as Servizio Ordini
participant P as Servizio Pagamenti
O->>P: POST /addebita - timeout 2s
Note over P: elaborazione lenta
O-->>O: scaduti 2s - annulla la chiamata
O->>O: libera il thread e gestisce l'errore
P-->>O: risposta tardiva - ignorataOrdini chiama Pagamenti con un limite di 2 secondi. Pagamenti è lento. Allo scadere dei 2 secondi Ordini annulla la chiamata, libera le risorse e passa alla gestione dell'errore (un Retry, un Fallback, o un errore pulito all'utente). Se la risposta arriva dopo, viene scartata.
Quando usarlo: - Sempre, su ogni chiamata di rete: HTTP, database, code, cache. - Con valori diversi per connessione (brevi, pochi secondi) e per lettura della risposta (dipende dall'operazione). - Con un budget complessivo per richiesta: se l'utente aspetta al massimo 5 secondi, le chiamate interne devono sommare meno.
Quando NON usarlo / rischi:
- Timeout troppo corto: fai fallire chiamate che sarebbero andate bene, e sprechi lavoro già fatto dal servizio a valle.
- Timeout troppo lungo: non protegge da nulla. I valori di default delle librerie sono spesso infiniti o di minuti.
- Il timeout non annulla il lavoro lato server: Pagamenti può aver addebitato la carta anche se Ordini ha rinunciato. Serve idempotenza per riprovare in sicurezza.
Esempio pratico: Ordini chiama Pagamenti con timeout di 2 secondi e Magazzino con timeout di 500 millisecondi, perché la verifica della disponibilità è una lettura veloce. Il timeout di Pagamenti è più lungo perché l'addebito passa da un circuito esterno. Se Pagamenti non risponde entro 2 secondi, Ordini salva l'ordine in stato "pagamento in sospeso" e risponde all'utente, invece di restare appeso.
Pattern correlati: Retry con backoff esponenziale e jitter, Circuit Breaker, Fallback / Graceful Degradation, Idempotent Consumer.
Retry con backoff esponenziale e jitter
In una frase: se una chiamata fallisce per un errore temporaneo, riprovala poche volte, aspettando sempre di più e con un ritardo casuale.
Problema che risolve: molti errori sono transitori: un pacchetto perso, un pod che si sta riavviando, un picco di un secondo. Far fallire tutto l'ordine per un errore che svanisce da solo è uno spreco. Ma riprovare subito e sempre allo stesso ritmo trasforma un piccolo problema in un attacco al servizio che sta cercando di rialzarsi.
Come funziona:
flowchart LR
    mail["✉️ Notifiche"] -->|"1. subito"| t1["📨 Tentativo 1"]
    t1 -->|"429, aspetta 200ms + caso"| t2["📨 Tentativo 2"]
    t2 -->|"429, aspetta 400ms + caso"| t3["📨 Tentativo 3"]
    t3 -->|"inviata"| ext>"☁️ Provider email"]
    chiave[/"🔑 Chiave di idempotenza"/] -.->|"scarta i duplicati"| ext
sequenceDiagram
participant O as Servizio Ordini
participant M as Servizio Magazzino
O->>M: tentativo 1
M-->>O: errore 503
Note over O: attesa 100ms + jitter
O->>M: tentativo 2
M-->>O: errore 503
Note over O: attesa 200ms + jitter
O->>M: tentativo 3
M-->>O: 200 OKIl primo tentativo fallisce con un errore temporaneo (503, timeout, connessione rifiutata). Ordini aspetta un tempo base (100 ms) più una quantità casuale, poi riprova. A ogni fallimento il tempo base raddoppia: 100, 200, 400, 800 ms. Dopo un numero massimo di tentativi (tipicamente 3-5) si rinuncia e si passa al Fallback o all'errore.
Perché il jitter: se Magazzino cade per un secondo, mille richieste di Ordini falliscono nello stesso istante. Senza jitter, riprovano tutte dopo esattamente 100 ms, poi tutte dopo 200 ms: onde sincronizzate che colpiscono Magazzino proprio mentre si rialza. Questa è la retry storm. Il ritardo casuale distribuisce i tentativi nel tempo e trasforma l'onda in una pioggia leggera.
Quando usarlo: - Solo su errori transitori: timeout, 503, 429, errori di connessione. Mai su 400, 401, 404: riprovare un errore di validazione produce lo stesso errore. - Solo su operazioni idempotenti, o con una chiave di idempotenza: riprovare un addebito non idempotente può addebitare due volte. - Con un numero massimo di tentativi e un budget totale di tempo compatibile con il timeout del chiamante a monte.
Quando NON usarlo / rischi:
- Retry a cascata: se Carrello riprova 3 volte Ordini, che riprova 3 volte Pagamenti, una richiesta utente produce 9 chiamate a Pagamenti. Riprova in un solo livello, di solito il più vicino alla dipendenza.
- Senza Circuit Breaker: se la dipendenza è giù per dieci minuti, ogni retry è traffico inutile che la tiene giù.
- Su operazioni lente: 5 tentativi con timeout di 2 secondi sono 10 secondi di attesa per l'utente.
Esempio pratico: Notifiche invia email tramite un provider esterno che ogni tanto risponde 429 (troppo traffico). Il client riprova al massimo 4 volte con backoff 200, 400, 800, 1600 ms e jitter casuale fino al 50 percento. Ogni email ha un identificativo univoco inviato come chiave di idempotenza, così il provider scarta i duplicati se la prima richiesta era in realtà arrivata.
Pattern correlati: Timeout, Circuit Breaker, Idempotent Consumer, Dead Letter Queue.
Circuit Breaker
In una frase: quando una dipendenza fallisce troppo, smetti di chiamarla per un po' e fallisci subito, poi prova con cautela a riaprire.
Problema che risolve: Timeout e Retry gestiscono il singolo errore, ma se Pagamenti è giù da cinque minuti, ogni richiesta di Ordini paga comunque il timeout e i retry prima di fallire. L'utente aspetta secondi per un errore certo, e Pagamenti riceve un fiume di chiamate inutili proprio mentre cerca di ripartire.
Come funziona:
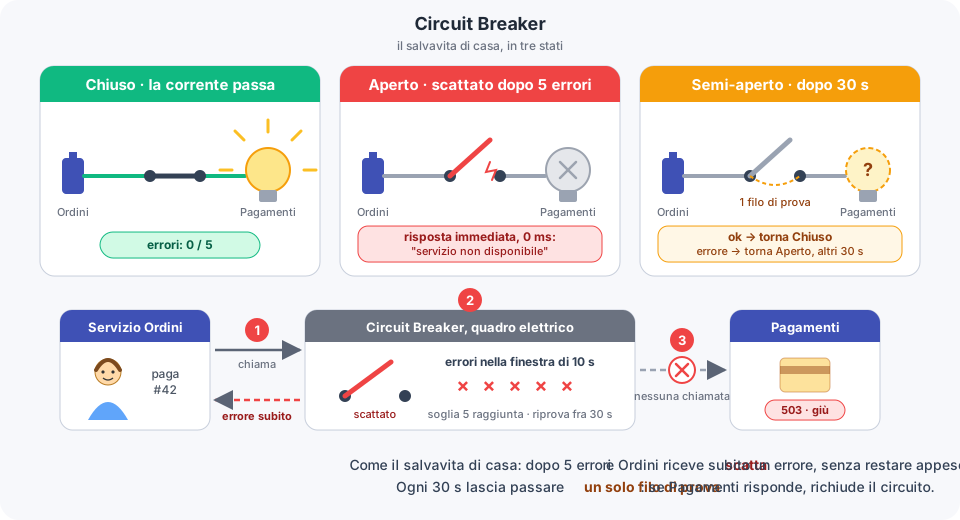
stateDiagram-v2
    [*] --> Closed
    Closed --> Open: troppi errori in finestra
    Open --> HalfOpen: scaduto il tempo di attesa
    HalfOpen --> Closed: chiamata di prova riuscita
    HalfOpen --> Open: chiamata di prova fallita
    Closed --> Closed: chiamate normali
    Open --> Open: fallisce subito senza chiamare
Il breaker avvolge la chiamata verso la dipendenza e ha tre stati. In Closed (chiuso, circuito normale) le chiamate passano e il breaker conta gli errori. Se gli errori superano una soglia in una finestra di tempo (es. 50 percento su 20 chiamate in 10 secondi), il breaker va in Open: le chiamate falliscono immediatamente senza toccare la rete. Dopo un tempo di attesa (es. 30 secondi) passa in HalfOpen: lascia passare una o poche chiamate di prova. Se riescono torna Closed, se falliscono torna Open e ricomincia l'attesa.
Quando usarlo: - Su dipendenze che possono restare giù per minuti: servizi esterni, database, altri microservizi. - Quando fallire subito è meglio che aspettare: l'utente vede un messaggio chiaro invece di una pagina che carica all'infinito. - Insieme a un Fallback: quando il breaker è aperto, servi la risposta degradata.
Quando NON usarlo / rischi:
- Un solo breaker per tutte le dipendenze: un errore su Catalogo non deve aprire il circuito verso Pagamenti. Un breaker per dipendenza, a volte per singola operazione.
- Soglie sbagliate: troppo sensibile si apre per un errore isolato, troppo tollerante non si apre mai. Parti dai dati reali di errore.
- Contare come errori anche i 4xx: un errore di validazione non vuol dire che la dipendenza è rotta.
- Senza metriche: un breaker che si apre deve generare un allarme, altrimenti il Fallback nasconde il guasto per giorni.
Esempio pratico: Ordini ha un breaker verso Pagamenti con soglia al 50 percento di errori su 20 chiamate e attesa di 30 secondi. Il provider di carte va giù. Dopo 10 errori il breaker si apre: per 30 secondi Ordini non chiama Pagamenti, salva gli ordini in stato "pagamento in sospeso" e risponde all'utente in pochi millisecondi. Ogni 30 secondi una chiamata di prova verifica se Pagamenti è tornato. Un allarme avvisa il team.
Pattern correlati: Timeout, Retry con backoff esponenziale e jitter, Fallback / Graceful Degradation, Bulkhead, State.
Bulkhead
In una frase: dai a ogni dipendenza il suo pool di risorse separato, così se una si satura le altre continuano a funzionare.
Problema che risolve: Ordini usa un unico pool di thread e connessioni per chiamare Pagamenti, Magazzino e Catalogo. Se Pagamenti diventa lento, le sue chiamate occupano tutto il pool. Le chiamate verso Magazzino e Catalogo, che risponderebbero in pochi millisecondi, non trovano più un thread libero. Un solo guasto blocca tutto.
Come funziona:
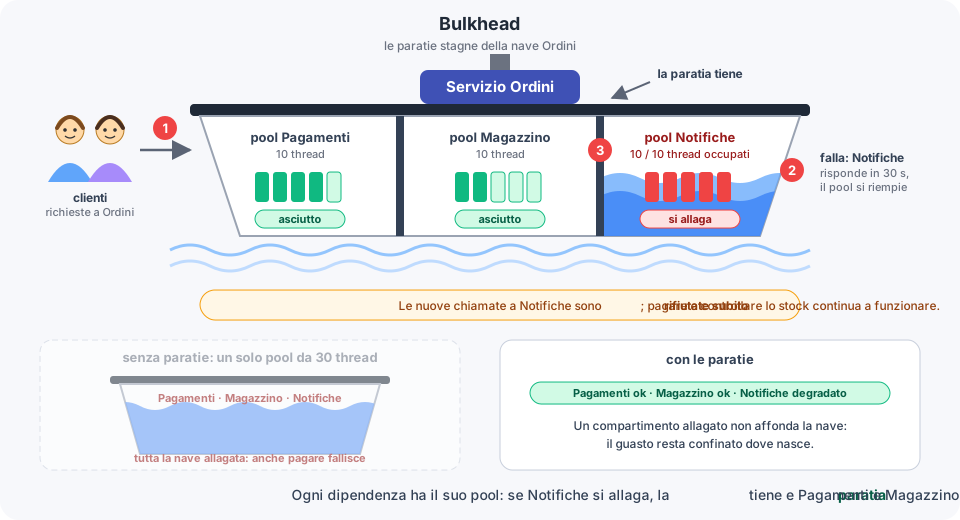
flowchart LR
    richieste["Richieste in ingresso"] --> ordini["Servizio Ordini"]
    ordini --> poolPag["Pool Pagamenti - 10 thread"]
    ordini --> poolMag["Pool Magazzino - 20 thread"]
    ordini --> poolCat["Pool Catalogo - 20 thread"]
    poolPag -->|"pieno - rifiuta"| pagamenti["Pagamenti - lento"]
    poolMag --> magazzino["Magazzino"]
    poolCat --> catalogo["Catalogo"]
Il nome viene dalle paratie stagne delle navi: se un compartimento si allaga, gli altri restano asciutti. Ordini assegna un pool separato a ogni dipendenza. Quando Pagamenti è lento, il suo pool di 10 thread si riempie e le nuove chiamate verso Pagamenti vengono rifiutate subito. I pool di Magazzino e Catalogo restano liberi e le funzionalità che non dipendono da Pagamenti continuano a lavorare.
Quando usarlo: - Quando un processo chiama più dipendenze con criticità o latenza diverse. - Per separare il traffico per tipo di cliente: un pool per le API pubbliche, uno per i processi interni, così un picco di utenti non blocca la fatturazione. - A livello di infrastruttura: deploy separati, pod separati, database separati per servizi con carichi diversi.
Quando NON usarlo / rischi: - Pool troppo piccoli: rifiuti chiamate legittime anche quando la dipendenza sta bene. Dimensiona dai dati reali di latenza e traffico. - Troppi pool frammentano le risorse: 10 pool da 5 thread sprecano più di 2 pool da 25. - Aggiunge complessità operativa: ogni pool è un parametro da monitorare e tarare.
Esempio pratico: Ordini separa i pool: 10 connessioni verso Pagamenti, 20 verso Magazzino, 20 verso Catalogo. Durante un rallentamento del provider di carte, il pool di Pagamenti si riempie e il checkout rifiuta le nuove richieste con un messaggio chiaro. Intanto la pagina del carrello, che chiama solo Magazzino e Catalogo, continua a rispondere in pochi millisecondi.
Pattern correlati: Circuit Breaker, Timeout, Load Shedding / Backpressure, Database per Service.
Rate Limiting / Throttling
In una frase: limita quante richieste un client può fare in un intervallo di tempo, e rifiuta o rallenta quelle in eccesso.
Problema che risolve: un client con un bug, un bot, o semplicemente un cliente molto grande può inviare migliaia di richieste al secondo e travolgere un servizio che ne regge cento. Senza un limite, un solo client degrada il servizio per tutti gli altri.
Come funziona:
flowchart LR
    bug(["🤖 Partner con un bug"]) -->|"3000 richieste"| secchio
    buono(["🧑 Partner normale"]) -->|"10 richieste"| secchio
    subgraph gw["🚪 API Gateway"]
        ricarica{{"⏳ Ricarica 100 al secondo"}} --> secchio[("🪣 Secchio, 200 gettoni")]
    end
    secchio -->|"un gettone, una richiesta"| cat["🛍️ Catalogo"]
    secchio -->|"secchio vuoto"| rifiuto>"🚫 429, riprova fra 1s"]
flowchart LR
client["Client"] --> gw["API Gateway - rate limiter"]
gw -->|"token disponibile"| catalogo["Servizio Catalogo"]
gw -->|"nessun token - 429"| rifiuto["Risposta 429 Too Many Requests"]
refill["Ricarica - 100 token al secondo"] -.-> bucket["Bucket - max 200 token"]
bucket -.-> gwL'algoritmo più usato è il token bucket (secchio di gettoni). Ogni client ha un secchio con una capacità massima (200 gettoni) che si ricarica a ritmo costante (100 gettoni al secondo). Ogni richiesta consuma un gettone. Se il secchio è vuoto, la richiesta viene rifiutata con 429 e un header Retry-After che dice quando riprovare. La capacità del secchio permette brevi picchi (fino a 200 richieste in un istante), mentre il ritmo di ricarica fissa la media sostenibile.
Quando usarlo: - Su API esposte all'esterno, per client o per chiave API. - Per proteggere risorse con capacità fissa: un database, un provider esterno che a sua volta ti limita. - Per dare priorità: limiti diversi per clienti paganti, clienti gratuiti, processi interni.
Quando NON usarlo / rischi:
- Limiti troppo bassi frustrano i client legittimi. Comunica i limiti nella documentazione e negli header di risposta.
- Rate limiting per IP penalizza utenti dietro lo stesso NAT (aziende, università).
- In un servizio con più istanze, un contatore locale non basta: serve uno stato condiviso (Redis) o accettare un limite approssimativo.
- Un 429 senza Retry-After spinge i client a riprovare subito, peggiorando le cose.
Esempio pratico: l'API pubblica di Catalogo concede 100 richieste al secondo per chiave API, con picchi fino a 200. Un partner con un bug in un ciclo riceve 429 dopo i primi 200 e il suo client, leggendo Retry-After, si ferma per un secondo. Gli altri partner non notano nulla. Il gateway espone gli header X-RateLimit-Remaining così i client sanno quanto margine hanno.
Pattern correlati: Load Shedding / Backpressure, Bulkhead, API Gateway, Retry con backoff esponenziale e jitter.
Fallback / Graceful Degradation
In una frase: quando una dipendenza fallisce, rispondi con qualcosa di meno buono ma utile invece di un errore.
Problema che risolve: la pagina prodotto chiama Catalogo per i dati, Magazzino per la disponibilità e un servizio di raccomandazioni per i prodotti simili. Se le raccomandazioni falliscono, mostrare un errore all'utente è assurdo: il prodotto esiste e si può comprare. Un fallimento secondario non deve rendere inutile l'intera risposta.
Come funziona:
flowchart LR
    cliente(["🧑 Cliente"]) -->|"1. apri prodotto"| cat["🛍️ Catalogo"]
    cat -->|"2. prodotti simili"| racc>"☁️ Raccomandazioni, giù"]
    racc -->|"3. errore"| cat
    cat -->|"4. piano B"| cache[("🗄️ Cache di 5 minuti fa")]
    cache -->|"5. pagina completa, simili da cache"| cliente
flowchart TD
richiesta["Richiesta pagina prodotto"] --> chiamata["Chiama Raccomandazioni"]
chiamata -->|"OK"| completa["Pagina completa"]
chiamata -->|"errore o breaker aperto"| cache{"Dato in cache stale?"}
cache -->|"sì"| stale["Pagina con raccomandazioni vecchie"]
cache -->|"no"| vuoto["Pagina senza sezione raccomandazioni"]Quando la chiamata fallisce (per timeout, per errore, o perché il Circuit Breaker è aperto), il servizio sceglie una risposta alternativa in ordine di qualità decrescente. Prima prova un valore in cache anche se vecchio (cache stale). Se non c'è, usa un valore di default (lista vuota, prodotti più venduti precalcolati). Solo come ultima risorsa nasconde la funzionalità. L'utente vede sempre una pagina che funziona.
Quando usarlo: - Per funzionalità secondarie: raccomandazioni, recensioni, contatori, badge "ultimi pezzi". - Quando un dato vecchio è meglio di nessun dato: prezzi di listino, descrizioni, immagini. - Insieme al Circuit Breaker: il fallback è la risposta da dare quando il circuito è aperto.
Quando NON usarlo / rischi:
- Mai su operazioni che modificano denaro o stock: un fallback su Pagamenti che "assume che sia andato bene" è un disastro.
- Nascondere i guasti: se il fallback funziona in silenzio, nessuno si accorge che le raccomandazioni sono giù da tre giorni. Ogni fallback va contato e messo in allarme.
- Dati stale in contesti dove la freschezza conta: mostrare "disponibile" da cache quando il magazzino è vuoto genera ordini non evadibili.
Esempio pratico: la pagina prodotto chiama Magazzino per la disponibilità con timeout di 300 ms. Se Magazzino non risponde, la pagina mostra la disponibilità letta dalla cache fino a 5 minuti prima, con un'avvertenza "disponibilità da confermare". Il checkout invece non usa fallback: se Magazzino non conferma lo stock, l'ordine non si completa. Ogni uso del fallback incrementa una metrica che allarma il team sopra una certa soglia.
Pattern correlati: Circuit Breaker, Timeout, CQRS, Null Object (non è un pattern GoF: un oggetto che non fa nulla al posto di None).
Dead Letter Queue
In una frase: i messaggi che non riesci a elaborare dopo vari tentativi finiscono in una coda separata, così non bloccano gli altri.
Problema che risolve: Notifiche consuma eventi OrdineCreato da una coda. Arriva un evento con un indirizzo email malformato. Il consumer fallisce, il messaggio torna in coda, il consumer lo rilegge e fallisce di nuovo. All'infinito. Tutti gli eventi dietro di lui restano fermi: un messaggio avvelenato blocca l'intera coda.
Come funziona:
flowchart LR
    ordini["📦 Ordini"] -->|"eventi"| coda[["📨 Coda OrdineCreato"]]
    coda --> mail["✉️ Notifiche"]
    mail -->|"fallisce 3 volte"| veleno[/"☠️ Evento con email nulla"/]
    veleno --> dlq[["📮 Dead Letter Queue"]]
    dlq -->|"allarme"| team(["👷 Team"])
    team -.->|"corretto, rimesso in coda"| coda
flowchart LR
ordini["Servizio Ordini"] --> coda["Coda OrdineCreato"]
coda --> notifiche["Consumer Notifiche"]
notifiche -->|"OK"| ack["Conferma - ack"]
notifiche -->|"errore - tentativo meno di 3"| coda
notifiche -->|"errore - 3 tentativi falliti"| dlq["Dead Letter Queue"]
dlq --> allarme["Allarme e analisi manuale"]
dlq -.->|"dopo la correzione"| codaIl consumer prova a elaborare il messaggio. Se fallisce, il messaggio torna in coda con un contatore di tentativi incrementato (spesso con un ritardo crescente). Dopo un numero massimo di tentativi (3-5), il broker sposta il messaggio nella Dead Letter Queue, una coda parallela che nessuno consuma in automatico. La coda principale prosegue. Un allarme avvisa il team, che analizza il messaggio, corregge il bug o il dato e, se ha senso, lo rimette in coda.
Quando usarlo: - Su ogni coda o topic con consumer che possono fallire: cioè praticamente sempre. - Quando l'ordine dei messaggi non è critico, o quando preferisci perdere l'ordine piuttosto che fermare tutto. - Insieme a un Retry con backoff per distinguere errori transitori (riprova) da errori permanenti (DLQ).
Quando NON usarlo / rischi:
- DLQ senza allarme e senza processo: diventa un cimitero di messaggi che nessuno guarda. Serve una metrica sulla dimensione e un responsabile.
- Quando l'ordine è vincolante: se OrdineAnnullato finisce in DLQ e OrdineSpedito viene elaborato, lo stato dell'ordine è incoerente. In questi casi fermare la partizione può essere meglio.
- Rimettere in coda senza aver corretto la causa: il messaggio torna in DLQ e si è solo sprecato tempo.
Esempio pratico: Notifiche consuma OrdineCreato. Un evento ha un campo email nullo per un bug in Ordini. Il consumer fallisce 3 volte con backoff 1, 5, 25 secondi, poi il broker sposta l'evento nella DLQ notifiche-dlq. La coda principale continua. Un allarme scatta quando la DLQ supera i 10 messaggi. Il team corregge il bug in Ordini, arricchisce i messaggi in DLQ con l'email letta dall'anagrafica e li rimette in coda.
Pattern correlati: Retry con backoff esponenziale e jitter, Idempotent Consumer, Messaggistica asincrona, Transactional Outbox.
Health Check
In una frase: ogni istanza espone endpoint che dicono se è viva e se è pronta a ricevere traffico, e l'orchestratore agisce di conseguenza.
Problema che risolve: un pod di Ordini è in deadlock: il processo gira ma non risponde. Un altro pod è appena partito e sta ancora caricando la configurazione. Senza un segnale, il load balancer manda traffico a entrambi e gli utenti vedono errori. Serve un modo standard per dire "sono rotto, riavviami" e "non sono ancora pronto, aspetta".
Come funziona:
flowchart LR
    k8s{{"☸️ Kubernetes"}} -->|"live ok, ready ok"| sano["🟢 Pod sano"]
    k8s -->|"ready no, niente traffico"| avvio["🟡 Pod in avvio"]
    k8s -->|"live no, riavvia"| morto["🔴 Pod in deadlock"]
    utenti(["🧑 Utenti"]) --> sano
    sano -.->|"ready controlla"| db[("🗄️ Database")]
flowchart LR
k8s["Kubernetes kubelet"] -->|"GET /health/live"| pod["Pod Ordini"]
k8s -->|"GET /health/ready"| pod
pod -->|"live fallisce"| restart["Riavvia il container"]
pod -->|"ready fallisce"| noTraffic["Toglie il pod dal Service - niente traffico"]
pod -->|"ready OK"| traffic["Riceve traffico"]
pod -.->|"ready controlla"| db["Connessione DB"]
pod -.->|"ready controlla"| broker["Connessione broker"]Liveness (/health/live) risponde alla domanda "il processo è vivo?". Deve essere leggerissima: un 200 se il processo risponde. Se fallisce più volte di seguito, Kubernetes riavvia il container. Readiness (/health/ready) risponde a "posso servire traffico adesso?". Controlla le dipendenze essenziali: connessione al database, cache calda, configurazione caricata. Se fallisce, Kubernetes toglie il pod dal bilanciamento ma non lo riavvia. Quando torna OK, il traffico riprende. Esiste anche la startup probe per servizi con avvio lento: finché non passa, le altre probe sono sospese.
Quando usarlo: - Sempre, su ogni servizio rilasciato su Kubernetes o dietro un load balancer. - Readiness durante i rilasci: il nuovo pod riceve traffico solo quando è pronto, e il vecchio smette di riceverne prima di spegnersi (graceful shutdown). - Readiness per scaricare un pod sovraccarico in modo temporaneo, senza riavviarlo.
Quando NON usarlo / rischi:
- Liveness che controlla le dipendenze: se il database è giù, tutti i pod falliscono la liveness e Kubernetes li riavvia a ciclo continuo. La liveness controlla solo il processo.
- Readiness che controlla dipendenze non essenziali: se le raccomandazioni sono giù, Catalogo non deve dichiararsi non pronto. Controlla solo ciò senza cui non puoi rispondere.
- Health check costosi: vengono chiamati ogni pochi secondi per ogni pod. Una query pesante nel readiness è un carico costante sul database.
- Soglie troppo aggressive: un singolo check fallito non deve riavviare nulla. Usa failureThreshold di almeno 3.
Esempio pratico: Ordini espone /health/live che risponde sempre 200 se il processo è attivo, e /health/ready che verifica la connessione al database e al broker con un ping leggero. Durante un rilascio, il nuovo pod fallisce la readiness per i primi 8 secondi mentre carica la configurazione: non riceve traffico. Quando il database fa manutenzione, i pod falliscono la readiness, escono dal bilanciamento e rientrano da soli a fine manutenzione, senza riavvii.
Pattern correlati: Circuit Breaker, Load Shedding / Backpressure, Rilascio Blue-Green e Canary, Service Discovery.
Load Shedding / Backpressure
In una frase: quando il carico supera la capacità, rifiuta subito una parte delle richieste (load shedding) o segnala a monte di rallentare (backpressure), invece di degradare per tutti.
Problema che risolve: Catalogo regge 1000 richieste al secondo. Durante una promozione ne arrivano 3000. Se le accetta tutte, le code interne si gonfiano, la latenza sale a decine di secondi e tutte le 3000 falliscono per timeout: servizio zero. Sarebbe meglio servirne 1000 bene e rifiutare 2000 subito.
Come funziona:
flowchart LR
    folla(["👥 Promozione, 3000 al secondo"]) --> carrello["🛒 Carrello"]
    carrello --> porta{{"🚪 Buttafuori, max 200 in volo"}}
    porta -->|"checkout prima, ricerca dopo"| cat["🛍️ Catalogo, regge 1000"]
    porta -->|"oltre la soglia"| rifiuto>"🚫 503, riprova fra 1s"]
    rifiuto -.->|"backpressure, rallenta"| carrello
    carrello -.->|"piano B"| cache[("🗄️ Cache locale")]
flowchart LR
carrello["Servizio Carrello"] -->|"3000 req/s"| catalogo["Servizio Catalogo - capacità 1000 req/s"]
catalogo --> coda{"Coda interna oltre soglia?"}
coda -->|"no"| elabora["Elabora - latenza normale"]
coda -->|"sì"| shed["Rifiuta subito con 503"]
shed -.->|"backpressure - Retry-After"| carrello
carrello -.->|"rallenta e usa fallback"| utente["Utente"]Load shedding: il servizio misura un indicatore di saturazione (lunghezza della coda, richieste in volo, CPU, latenza). Sopra una soglia rifiuta immediatamente le nuove richieste con 503, senza farle entrare. Il rifiuto costa microsecondi, così la capacità resta dedicata alle richieste che vengono accettate. Si possono rifiutare prima le richieste meno importanti (la ricerca prima del checkout).
Backpressure: il segnale di saturazione risale la catena. Il chiamante riceve il 503 con Retry-After e rallenta: riduce la concorrenza, mette in coda, usa un Fallback. Nei sistemi a stream (Kafka, reactive streams) è il consumer che dice al produttore quanti messaggi è pronto a ricevere, e il produttore non manda di più.
Quando usarlo: - Su servizi con picchi prevedibili oltre la capacità: promozioni, lanci, orari di punta. - Quando puoi distinguere richieste critiche da richieste sacrificabili. - Nelle pipeline asincrone, per evitare che un produttore veloce sommerga un consumer lento.
Quando NON usarlo / rischi: - Soglia tarata male: rifiuti traffico anche quando ci sarebbe margine. Parti dalla latenza misurata, non dalla CPU. - Chiamanti che non rispettano il segnale e riprovano subito: il load shedding diventa inutile. Serve Retry con backoff dall'altra parte. - Scaricare richieste a caso invece che per priorità: rifiutare un checkout per servire una ricerca è una scelta sbagliata.
Esempio pratico: Catalogo tiene al massimo 200 richieste in volo. Oltre questa soglia risponde 503 con Retry-After: 1. Le richieste che arrivano dal checkout hanno un header di priorità e vengono scaricate per ultime. Carrello, ricevendo i 503, riduce la concorrenza verso Catalogo e mostra i prodotti dalla cache locale. Durante la promozione, il 95 percento degli utenti vede la pagina normale e il 5 percento vede una versione da cache: nessuno vede un timeout.
Pattern correlati: Rate Limiting / Throttling, Bulkhead, Fallback / Graceful Degradation, Messaggistica asincrona.
Come si combinano
I pattern non sono alternativi: in una chiamata uscente si impilano come strati, ciascuno con un compito. L'ordine tipico, dall'esterno verso la rete, è questo.
flowchart LR
    logica["Logica di Ordini"] --> fallback["Fallback"]
    fallback --> bulkhead["Bulkhead - pool dedicato"]
    bulkhead --> breaker["Circuit Breaker"]
    breaker --> retry["Retry con backoff"]
    retry --> timeout["Timeout"]
    timeout --> rete["Chiamata a Pagamenti"]
Si legge in due direzioni. Dall'interno verso l'esterno, nella chiamata: il Timeout avvolge la singola chiamata di rete e la fa fallire entro il limite. Il Retry avvolge il Timeout e riprova la chiamata fallita, poche volte, con backoff e jitter. Il Circuit Breaker avvolge il Retry e conta gli esiti finali: se fallisce troppo, blocca tutto prima ancora di tentare. Il Bulkhead avvolge il breaker e limita quante chiamate concorrenti possono entrare nello strato sottostante. Il Fallback è lo strato più esterno: qualunque cosa fallisca sotto, decide cosa rispondere alla logica.
Due regole pratiche. Primo, il retry sta dentro il breaker, non fuori: così il breaker vede un solo esito per operazione logica e non uno per tentativo. Secondo, il budget di tempo è coerente: se il Timeout è 2 secondi e il Retry fa 3 tentativi, lo strato a monte deve tollerare almeno 6 secondi più i backoff, altrimenti scade prima che il retry finisca.
I pattern restanti lavorano in altri punti: Rate Limiting e Load Shedding proteggono il lato che riceve, non quello che chiama. Health Check parla con l'orchestratore. Dead Letter Queue vive nel broker, per i flussi asincroni.
Come scegliere
flowchart TD
    start["Stai facendo una chiamata verso un altro servizio?"] -->|"sì"| timeout["Metti sempre un Timeout"]
    start -->|"no"| ricevi["Stai ricevendo traffico o messaggi?"]
    timeout --> transitorio{"Gli errori sono transitori e l'operazione è idempotente?"}
    transitorio -->|"sì"| retry["Retry con backoff e jitter"]
    transitorio -->|"no"| giuMinuti{"La dipendenza può restare giù per minuti?"}
    retry --> giuMinuti
    giuMinuti -->|"sì"| breaker["Circuit Breaker"]
    giuMinuti -->|"no"| piuDip{"Chiami più dipendenze dallo stesso processo?"}
    breaker --> piuDip
    piuDip -->|"sì"| bulkhead["Bulkhead"]
    piuDip -->|"no"| degradata{"Esiste una risposta degradata accettabile?"}
    bulkhead --> degradata
    degradata -->|"sì"| fallback["Fallback"]
    ricevi -->|"sì, da client esterni"| rate["Rate Limiting"]
    ricevi -->|"sì, con picchi oltre capacità"| shed["Load Shedding e Backpressure"]
    ricevi -->|"sì, da una coda"| dlq["Dead Letter Queue"]
    ricevi -->|"sì, da un orchestratore"| health["Health Check"]